Mistral ha publicado los pesos de Mistral Large 4, su modelo de IA más grande, y cualquiera puede descargarlos desde Hugging Face sin registrarse ni pedir permiso. Los pesos, también llamados parámetros, son los números que el modelo ajustó durante su entrenamiento y que guardan lo que aprendió. Tenerlos permite ejecutarlo en máquinas propias, fuera de los servidores de Mistral. La empresa francesa los liberó el 29 de octubre, tres semanas después de abrir una versión de prueba por API.
La licencia permite usarlo, modificarlo y venderlo sin pagar, también dentro de una empresa. La única excepción es ofrecérselo a otros como servicio desde servidores propios, algo que exige antes un contrato comercial con Mistral. El obstáculo para la mayoría es el tamaño, porque la versión completa ocupa 1,06 terabytes. Qué significa exactamente «pesos abiertos», y qué se queda fuera, lo explicamos en nuestra guía sobre modelos de pesos abiertos.
Un billón de parámetros, pero solo 49.000 millones trabajando a la vez
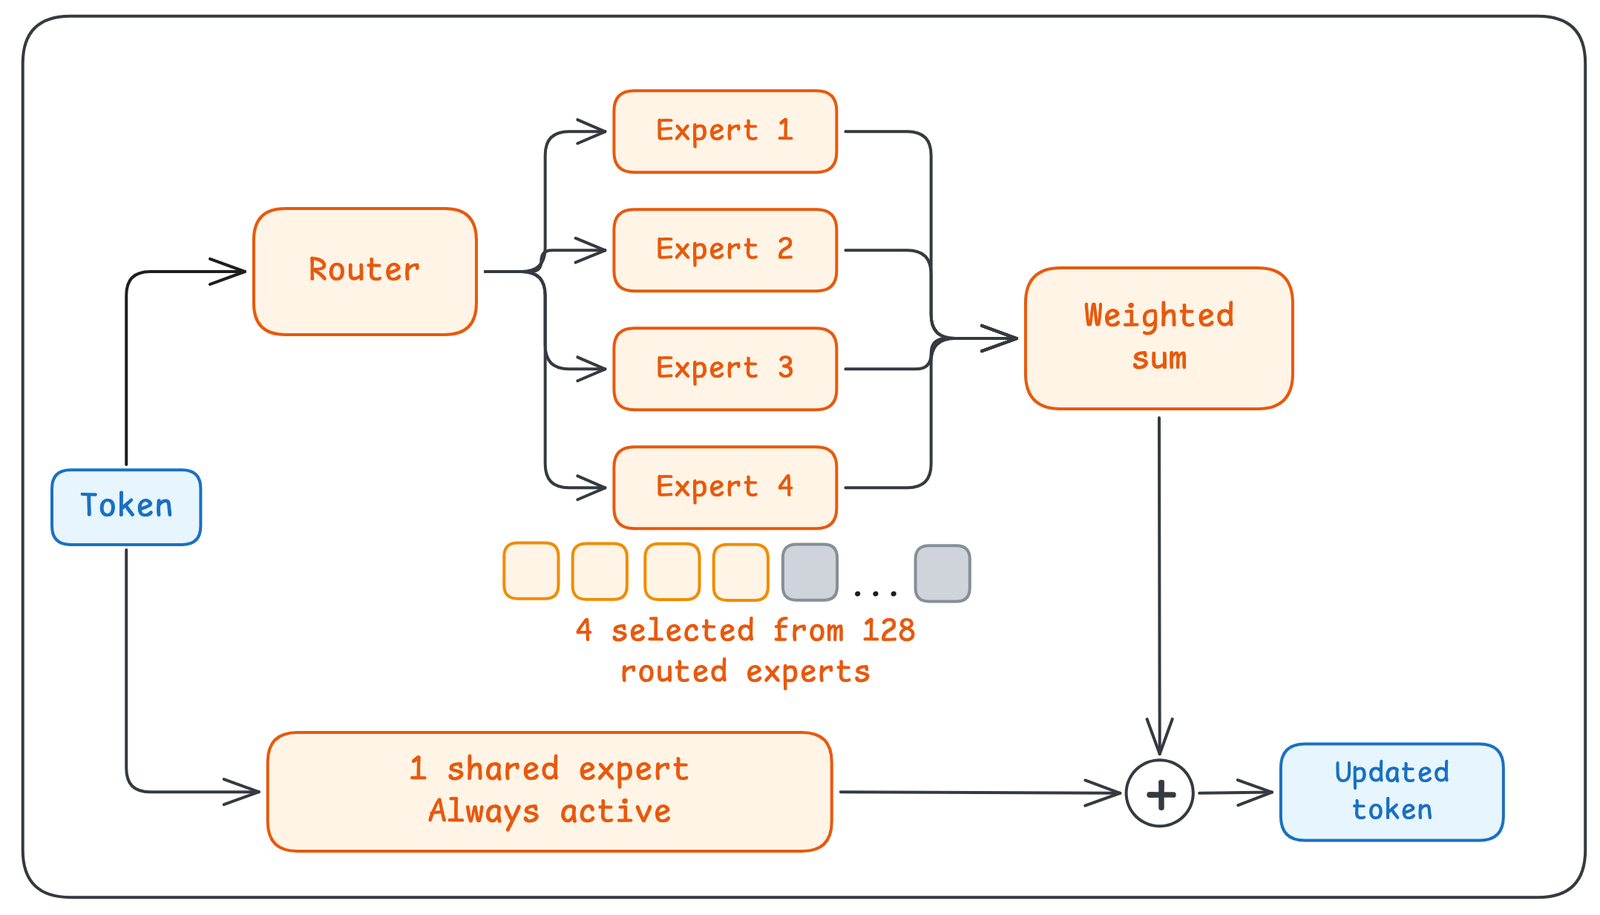
Large 4 tiene unos 1,05 billones de parámetros, aunque no los usa todos para cada palabra. Es lo que se llama una mezcla de expertos. El modelo procesa el texto en capas, etapas de cálculo puestas una detrás de otra, y según el análisis de Hugging Face casi todas contienen 128 bloques especializados, los llamados expertos. Para cada token, el trozo de texto con el que trabaja el modelo, un selector elige 4 de esos bloques. A ellos se suma un quinto bloque común que participa siempre. La ficha del modelo cifra en unos 49.000 millones los parámetros activos por token, 52.000 millones si se cuentan las capas de entrada y salida.
La mezcla de expertos abarata el cálculo, que para cada token se parece al de un modelo de unos 50.000 millones de parámetros. No ahorra memoria, porque el selector puede necesitar cualquiera de los bloques en el token siguiente y el billón entero tiene que estar cargado en memoria.
Acepta texto e imágenes y responde con texto. Su ventana de contexto, el material que puede tener delante en una misma petición, llega al millón de tokens, aunque las configuraciones de ejemplo de Hugging Face la limitan a 131.072. Mistral añade tres niveles de razonamiento, que regulan cuánto elabora el modelo antes de contestar (bajo, medio y alto, que viene activado por defecto), y asegura que domina más de 160 idiomas.
Qué ordenador hace falta para ejecutarlo
Mistral ofrece dos versiones oficiales. La principal guarda cada parámetro en un byte, así que sus 1,05 billones de parámetros suman 1,06 TB repartidos en 54 archivos. Hugging Face la despliega en un servidor con ocho NVIDIA H200, tarjetas gráficas de centro de datos que hacen los cálculos del modelo. Juntas reúnen algo más de 1,1 TB de memoria, lo justo para cargarlo entero.
La segunda, llamada NVFP4, guarda la mayoría de los parámetros con 4 bits, medio byte, y baja a unos 610 GB. Está pensada para las tarjetas de la generación Blackwell de NVIDIA, como la B200 o la B300, que tienen circuitos dedicados a ese formato. Dell, por ejemplo, la instala en un servidor con cuatro B300.
Para un particular, lo más cercano son las versiones comprimidas en formato GGUF que han preparado el equipo de llama.cpp y Unsloth. Las diferencias entre formatos están en nuestra guía de GGUF y safetensors. La más pequeña ocupa 233 GB y, para las de 2 bits, Unsloth recomienda entre 384 y 512 GB de memoria. Hugging Face probó la versión de 2 bits de llama.cpp en un Mac Studio con chip M3 Ultra y 512 GB de memoria unificada, la que comparten el procesador y la gráfica, y midió unos 15 tokens por segundo. Comprimir tanto suele costar precisión, y ni Mistral ni Hugging Face han publicado cuánta pierde esta versión.
Es un listón parecido al de Muse Spark Open, el modelo abierto de Meta, que también necesitaba un Mac de 512 GB en su versión más comprimida. En un portátil o en un PC de juegos normal no cabe.
Cómo se usa sin ese equipo y cuánto cuesta
Quien no tenga ese hardware puede usarlo a través de internet. Mistral lo sirve en su API y en Mistral Studio, y el modelo también está en OpenRouter, en los servicios alojados de NVIDIA y en Microsoft Foundry.
La documentación de Mistral fija el precio de su API en 0,70 dólares por cada millón de tokens que el modelo lee, 0,07 si ese texto ya se le había enviado antes y sigue guardado en caché, y 2,10 dólares por cada millón que escribe. La empresa publica la tarifa solo en dólares. Cómo se convierte un precio por millón de tokens en una factura real lo contamos en qué es una API de IA.
Para servidores propios, Mistral y Hugging Face publican instrucciones para vLLM y SGLang, dos programas que ponen el modelo a disposición de otras aplicaciones, y contenedores listos para usar. Hugging Face también enseña a ajustarlo con ejemplos propios, aunque su receta utiliza un servidor con ocho tarjetas B300.
Lo que dice Mistral de su rendimiento
Las cifras de rendimiento proceden de Mistral, que presenta Large 4 como un modelo fuerte en programación, en agentes (sistemas que encadenan tareas por su cuenta en vez de limitarse a responder) y en ciberseguridad. En el índice de agentes de programación de Artificial Analysis le atribuye un 48%, empatado con GLM-5.3 y con un 47% menos de tokens gastados por tarea. En una comparación de código a ciegas con evaluadores humanos, dice que solo queda por detrás de Claude Opus 5.5 entre los modelos evaluados. También afirma que rechaza el 96,6% de las peticiones maliciosas de ciberataque de sus pruebas, el porcentaje más alto que ha medido entre modelos abiertos.
El informe técnico que permitiría revisar cómo se hicieron esas pruebas todavía no está publicado. Mistral sí detalla que entrenó el modelo desde cero en sus centros de datos europeos, con 3.800 chips NVIDIA Grace Blackwell según la ficha. Con los pesos descargables, una empresa o una administración española puede tener un modelo de primer nivel en sus propios servidores, sin enviar documentos a otra compañía, siempre que compre o alquile las máquinas descritas más arriba.
La conversación empieza aquí
Accede con una cuenta de apoyo para comentar. Entrar
Todavía no ha comentado nadie. ¿Estrenas tú?