Meta ha presentado Muse Wonder y Muse Wonder Full, dos modelos orientados a agentes que trabajan con herramientas y aplicaciones. Desde el 12 de octubre, Wonder está disponible en la Meta Model API y Muse Code. Full se ofrece a suscriptores de Muse Code, mientras la llegada de Wonder a la aplicación Muse empezará por suscriptores en un despliegue posterior.
El lanzamiento añade otro competidor a la semana en la que Gemini 4 Argon amplió su acceso. En ambos casos interesa separar la capacidad del modelo del producto donde se utiliza. Acceder a una API para construir aplicaciones no significa encontrar ya todas sus funciones en un chat de consumo.
Recordar una preferencia y mantener el trabajo
Meta llama Active Memory a la capacidad de recuperar información relevante de conversaciones anteriores. Active Focus describe la persistencia durante un encargo, con intentos alternativos y recuperación ante errores. Son capacidades anunciadas por Meta, no una experiencia de uso que hayamos medido.
La explicación técnica de Meta sitúa esas funciones en tareas como modificar código y comprobar el resultado o trabajar con documentos. Recordar una preferencia puede evitar repetir una instrucción, pero el recuerdo también necesita actualizarse cuando cambias de opinión.
La ficha del modelo declara entradas de texto, imagen, vídeo y audio, salida de texto y una ventana de un millón de tokens. Esa ventana es el material disponible para una petición. La memoria entre conversaciones es otra función, como explicamos en por qué una IA pierde el contexto.
La tabla de resultados no es una prueba de cualquier encargo
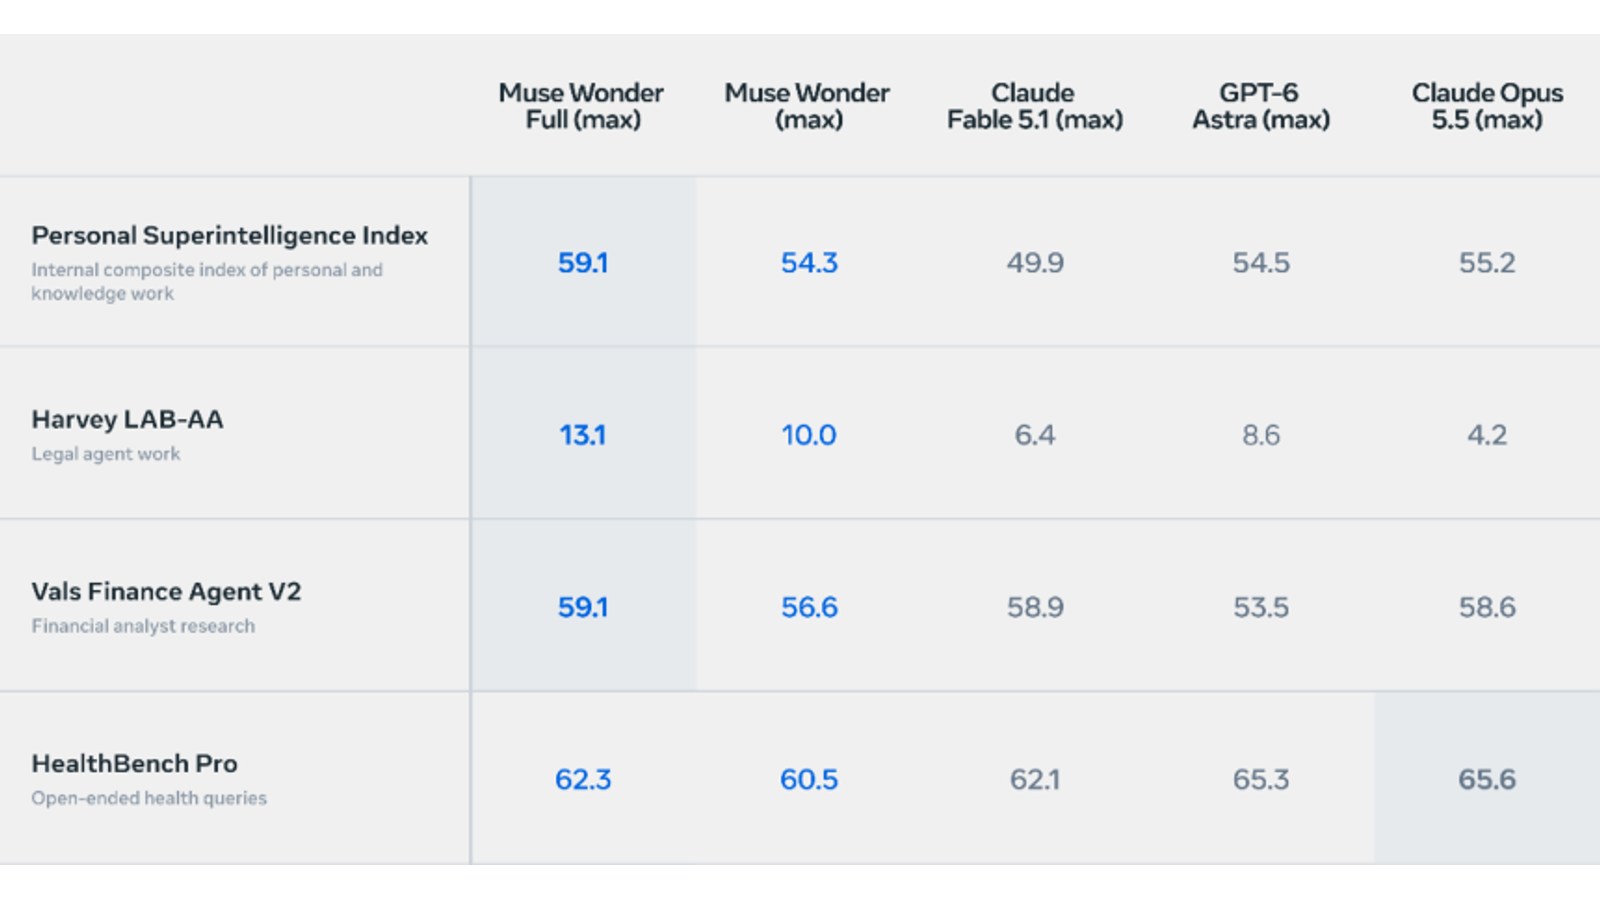
Meta compara los modelos mediante varias pruebas, con resultados internos y otros procedentes de evaluadores o proveedores externos. Su ficha advierte de que algunas comparaciones de programación utilizan herramientas distintas. La configuración que rodea al modelo también puede cambiar el resultado.
Una puntuación sobre tareas seleccionadas sirve para acotar una capacidad. No determina por sí sola cuánto costará completar tu proyecto ni cuántas correcciones necesitará. Para valorar un agente, importa comprobar el trabajo entregado, las acciones realizadas y el consumo permitido, además de leer la clasificación.
La conversación empieza aquí
Accede con una cuenta de apoyo para comentar. Entrar
Todavía no ha comentado nadie. ¿Estrenas tú?