Antes de descargar veinte gigas de un modelo de IA, mira qué formato acepta el programa que vas a utilizar. Si pide GGUF, busca una versión GGUF compatible con ese programa y esa arquitectura. Si pide safetensors, sigue las instrucciones del repositorio: puede necesitar una carpeta con varios archivos, no una sola descarga. Elegir el formato empieza por la aplicación, no por decidir qué extensión parece más avanzada.
GGUF y safetensors guardan los pesos del modelo, los valores que el programa utiliza para generar sus respuestas. No son modelos distintos por definición, ni una clasificación de calidad. El mismo modelo puede distribuirse en varios formatos y con diferentes niveles de compresión.
Qué cambia entre GGUF y safetensors
La documentación de Hugging Face sobre GGUF lo describe como un formato binario pensado para cargar modelos y ejecutar inferencia con herramientas como llama.cpp. Puede reunir pesos y metadatos en un archivo, una distribución cómoda para aplicaciones locales. También existen modelos divididos en varias partes, por lo que GGUF no significa necesariamente una única descarga.
Safetensors almacena tensores y evita los riesgos de deserialización propios de formatos basados en pickle. No incluye por ese motivo toda la configuración necesaria para ejecutar el modelo, ni certifica que un repositorio entero sea seguro. El programa puede necesitar, además, configuración y archivos del tokenizador, que convierte el texto en las unidades que procesa el modelo.
Tampoco vale la regla de que Ollama solo acepta GGUF. Sus instrucciones de importación contemplan tanto GGUF como modelos safetensors compatibles. La arquitectura admitida y el procedimiento importan tanto como el formato.
La cuantización se comprueba por separado
Un archivo GGUF puede contener un modelo cuantizado, pero la extensión no indica cuántos bits utiliza ni cuánto ocupa. La cuantización a 4 u 8 bits es otra decisión: reduce memoria a cambio de cambios en la precisión de los pesos. El resultado depende del modelo y del método, no de una equivalencia universal entre menos bits y peor respuesta.
Para comparar dos descargas, revisa el nombre exacto del modelo, su versión, la cuantización declarada y los requisitos del programa. Dos archivos que ocupen lo mismo pueden pertenecer a modelos diferentes. Y el tamaño en disco no es toda la memoria que necesitará una sesión: el contexto y la configuración de ejecución también cuentan.
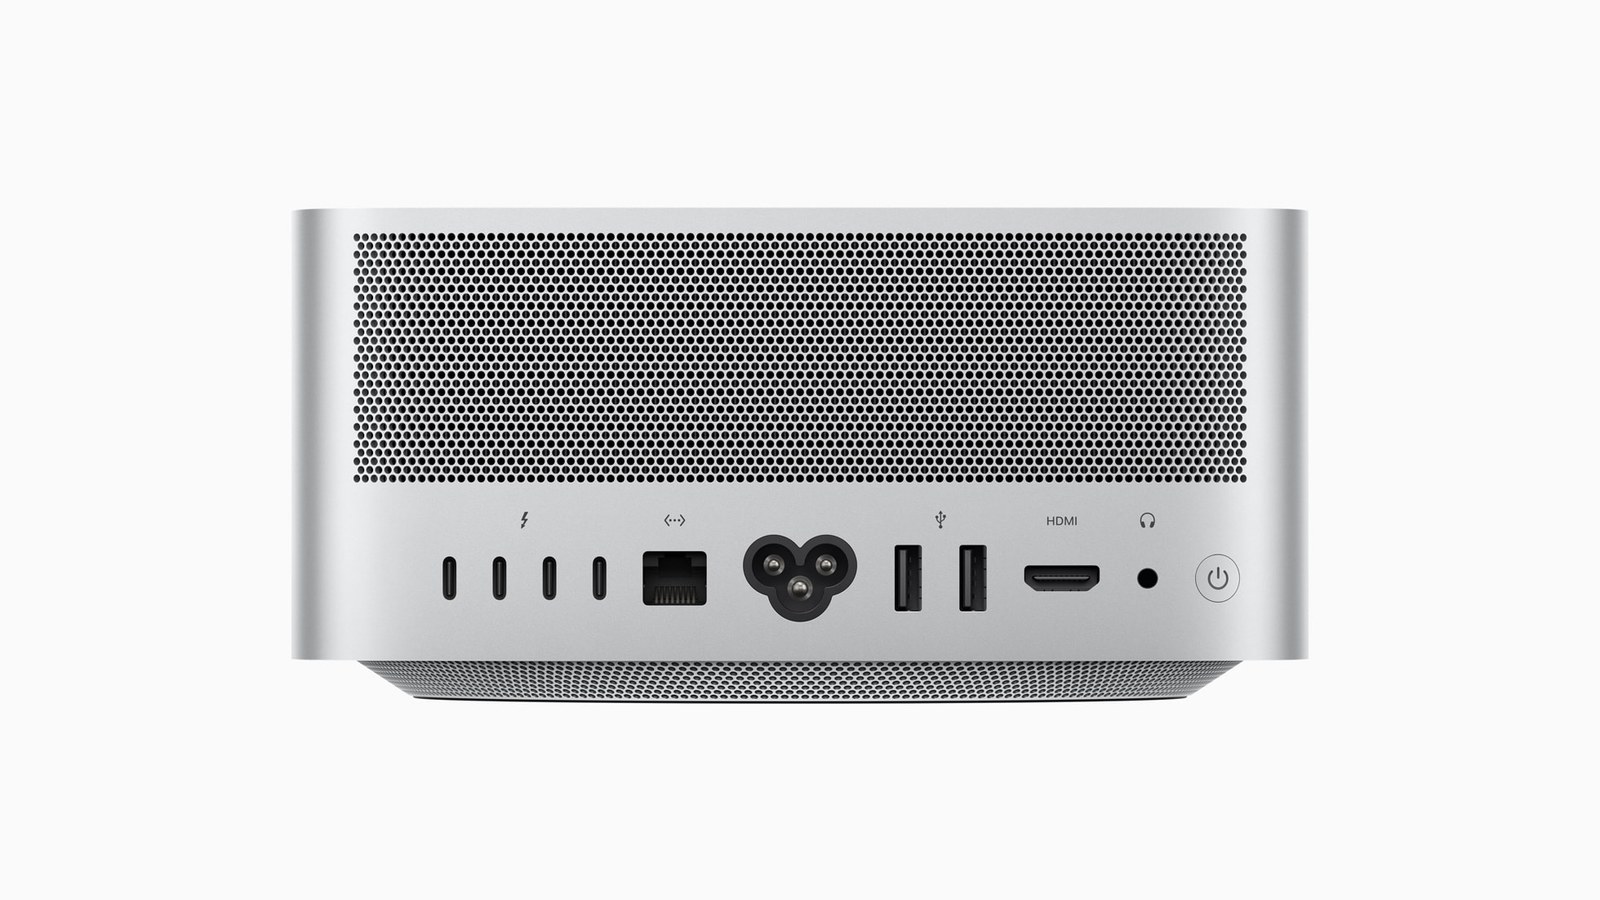
Las fotos de Mac Studio de esta guía son ilustrativas. No representan una prueba de rendimiento ni un requisito de compra. Lo primero es comprobar si tu equipo puede cargar el modelo elegido, como explicamos en la comparación entre IA local e IA en la nube.
Una comprobación rápida antes de descargar
Abre la documentación de tu aplicación y confirma formato y arquitecturas admitidas. Después lee la ficha del modelo, su licencia y el procedimiento recomendado. Descarga la variante que encaje con tu memoria y conserva las demás piezas que la aplicación solicite.
Si importas safetensors en Ollama, sigue el procedimiento para la carpeta del modelo y crea su configuración de importación. Si usas GGUF dividido en partes, conserva los nombres y las piezas que pide su documentación. No renombres un archivo safetensors a .gguf: cambiar el nombre no convierte su contenido.
Prueba el modelo con una petición corta antes de ampliar el contexto. Si falla, anota el mensaje exacto y comprueba primero formato, arquitectura, archivos ausentes y memoria disponible. Descargar una versión más grande sin resolver cuál de esos requisitos falla solo añade otra descarga a la lista.
La conversación empieza aquí
Accede con una cuenta de apoyo para comentar. Entrar
Todavía no ha comentado nadie. ¿Estrenas tú?