Microsoft ha publicado en la revista Science un sistema de inteligencia artificial que acertó el diagnóstico en el 83,2% de 304 casos clínicos muy difíciles, sacados de los casos que publica el New England Journal of Medicine (NEJM). Los médicos generalistas que resolvieron los mismos casos acertaron el 36,1%. El sistema se llama MAI-DxO y el artículo salió el 22 de octubre de 2026, firmado por investigadores de Microsoft, entre ellos Mustafa Suleyman, director de Microsoft AI.
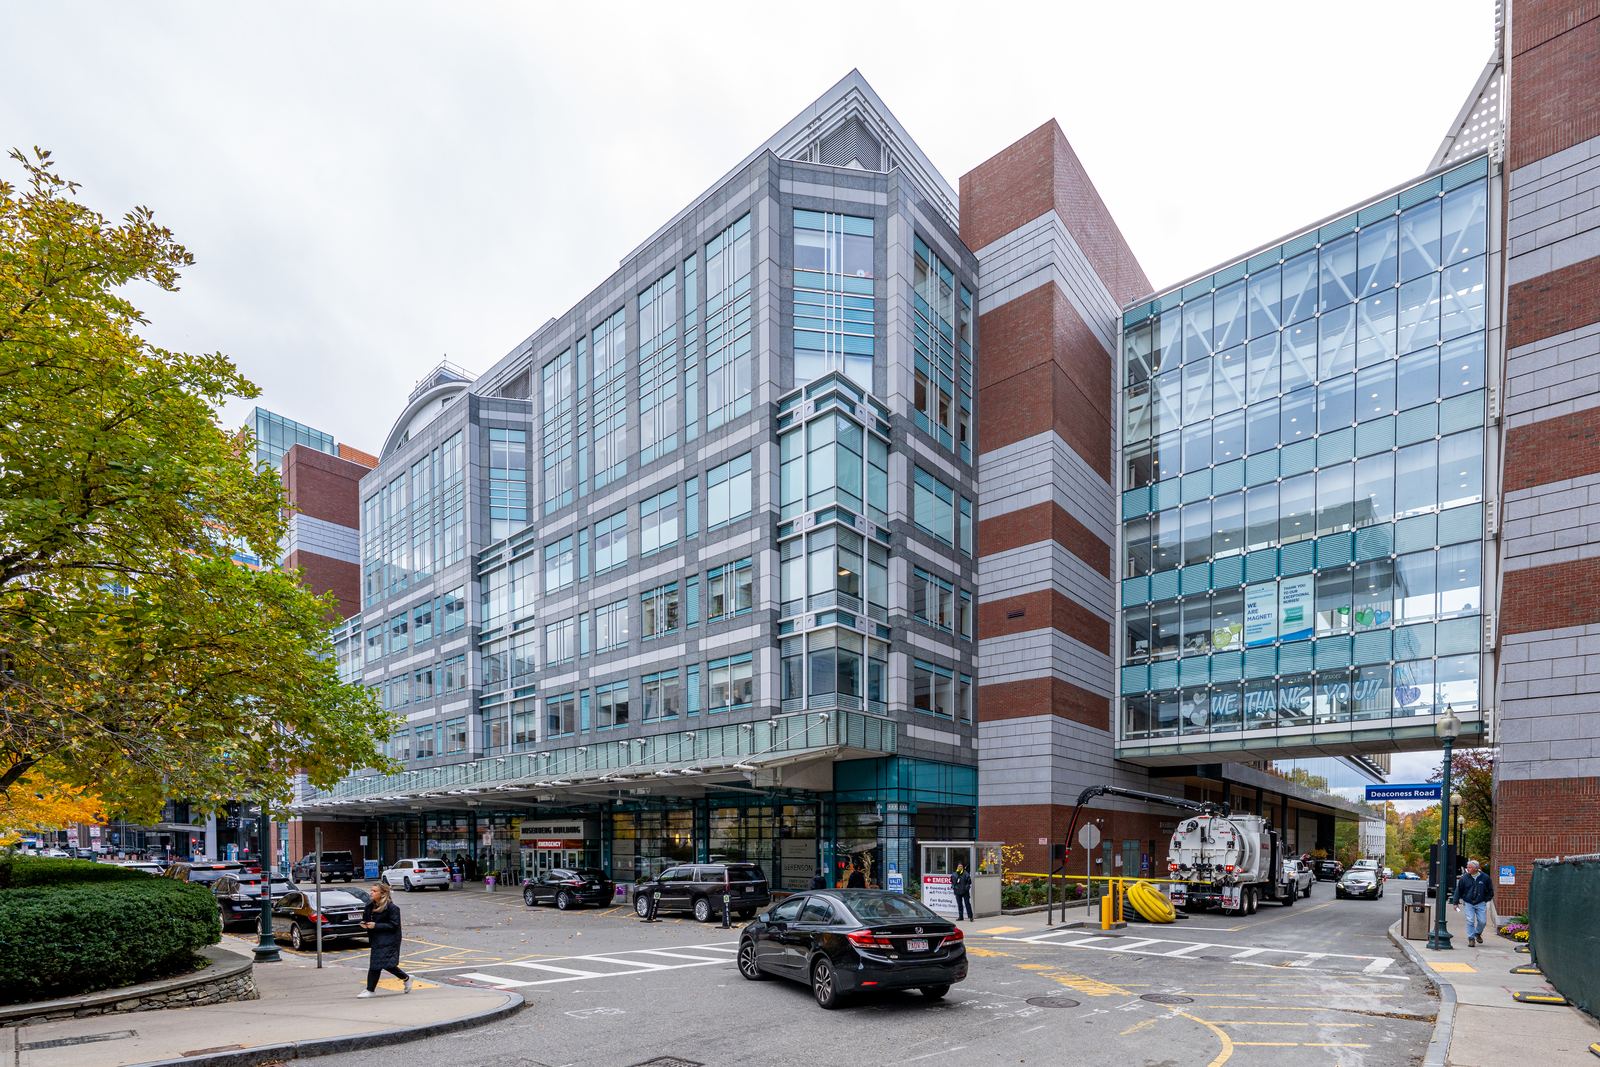
El resultado sale de una simulación por ordenador con casos ya publicados, en la que los médicos trabajaron cada uno por su cuenta y sin especialistas. MAI-DxO todavía no ha atendido a ningún paciente. La primera prueba con pacientes reales se hará en el hospital Beth Israel Deaconess de Boston.
Un equipo de médicos virtuales que discute cada caso
MAI-DxO es un programa que dirige a un modelo de lenguaje ya existente, el tipo de IA que hay detrás de los chatbots, como GPT-5 de OpenAI, para que trabaje como un pequeño equipo médico. Microsoft lo llama orquestador porque el conocimiento médico lo pone el modelo, y MAI-DxO se encarga de repartir el caso entre varios agentes de IA, copias del modelo con una tarea concreta cada una, y de coordinar lo que deciden.
En la versión preliminar del estudio, publicada en junio de 2025, Microsoft describía cinco papeles que interpreta el mismo modelo. Uno mantiene una lista con los tres diagnósticos más probables y la corrige con cada dato nuevo. Otro elige las pruebas que mejor separan esas opciones. Un tercero hace de abogado del diablo y busca datos que contradigan la hipótesis favorita, para que el equipo no se aferre a la primera idea. El cuarto vigila el gasto y propone pruebas más baratas cuando sirven igual, y el quinto comprueba que todo lo que se pide tenga sentido.
Después de cada ronda de debate, el panel elige entre tres acciones: preguntar al paciente, pedir una prueba o dar el diagnóstico. Si pide un análisis o una resonancia, recibe el resultado y vuelve a discutir con esa información.
Cómo se hizo el examen
Los casos del NEJM son historias de pacientes reales que en su día desconcertaron a sus médicos y que la revista publica con el diagnóstico final. Microsoft los convirtió en una prueba interactiva llamada SDBench. Quien diagnostica solo recibe al principio un resumen breve, por ejemplo la edad del paciente y el motivo por el que acude, y tiene que pedir todo lo demás.
Esas preguntas y peticiones las contesta otro modelo de IA que tiene el informe completo y hace a la vez de paciente y de laboratorio. Solo entrega lo que un médico obtendría al preguntar o al pedir esa prueba, sin pistas ni interpretaciones. Un tercer modelo hace de juez, compara el diagnóstico final con el publicado y decide si es correcto. Así se mide algo que un examen tipo test no recoge, porque en el test todos los datos llegan de golpe y en la consulta hay que decidir qué buscar. Microsoft ha liberado parte de SDBench para que otros prueben sus sistemas con el mismo método.
El estudio añadió un segundo grupo de casos más corrientes, pacientes ingresados desde urgencias que proceden de MIMIC-IV-ED, una base de datos con visitas reales a las urgencias del Beth Israel Deaconess. En esos casos MAI-DxO acertó el 80,3% y los médicos, el 46,8%.
Contra qué médicos compitió
Los rivales humanos fueron médicos de atención primaria y de medicina interna general, cada uno trabajando solo, según TechCrunch. No había especialistas ni equipos, que son quienes suelen ocuparse de casos tan complejos en un hospital. Microsoft da dos cifras para ellos: un 22% de aciertos sin consultar nada y un 36% cuando podían usar libros de texto e internet. Es decir, el 83,2% de la IA duplica con creces el acierto de los médicos con libros e internet y casi lo cuadruplica frente a los que no consultaban nada.
En la versión de 2025 participaron 21 médicos de Estados Unidos y Reino Unido, con una mediana de 12 años de experiencia, que no podían preguntar a colegas ni usar buscadores u otras IA. Esa prohibición de usar buscadores no encaja del todo con el 36% con internet que da ahora Microsoft, y ni Microsoft ni TechCrunch detallan si la muestra o las reglas cambiaron en la versión que ha publicado Science.
Cuánto cuestan las pruebas que pide
Cada pregunta y cada prueba tienen un precio simulado, porque un diagnóstico que acierta a base de pedirlo todo no sirve en un hospital. En la versión de 2025, cada ronda de preguntas al paciente costaba 300 dólares y las pruebas se valoraban con la lista de precios de 2023 de un gran sistema sanitario de Estados Unidos. No es lo que pagaría un hospital español, pero permite medir a la IA y a los médicos con la misma regla.
Según los datos que recoge TechCrunch, GPT-5 por sí solo acertó el 78,9% de los casos difíciles y gastó unos 8.400 dólares en pruebas por caso. Dirigido por MAI-DxO, gastó unos 3.000 dólares menos por caso, en torno a 5.400, y acertó unos cuatro puntos más. Microsoft añade que ningún otro método, humano o de IA, fue a la vez más preciso y más barato que MAI-DxO en los dos grupos de casos.
Cuánto mérito es del modelo y cuánto del panel
TechCrunch lee en los propios datos del estudio que pesa más el modelo de base que el panel. GPT-5.5, lanzado en abril de 2026, acertó por sí solo el 72% de los casos difíciles. Gemini 2.5 Flash, un modelo más pequeño de Google, se quedó por debajo incluso con la ayuda del panel, que lo subió del 46,4% a casi el 69%. Con GPT-5.5 el panel también sumó en los casos difíciles, hasta casi el 87%, pero en los de urgencias el acierto rondó el 85% con y sin MAI-DxO.
Los investigadores de Microsoft explican que la ganancia se reduce cuando el modelo ya acierta casi todo. Si la lectura de TechCrunch es correcta, para un hospital pesará más la calidad del modelo que hay debajo que la forma de organizarlo.
Lo que el estudio no demuestra
Los casos del NEJM se eligen precisamente por ser raros y didácticos. Un buen resultado con ellos no dice cómo se comportaría MAI-DxO con un dolor de espalda o una fiebre corriente, con datos incompletos o con un paciente que empeora en una hora. Microsoft ya reconocía en 2025 que faltaba probarlo con consultas habituales.
Tampoco hay todavía una comprobación independiente. El estudio lo firman investigadores de Microsoft, entre ellos Suleyman y Eric Horvitz, director científico de la empresa, y el sistema no tiene aprobación para uso clínico. Los propios autores escriben que los resultados se obtuvieron en un entorno de prueba controlado.
Por eso MAI-DxO no sustituye a un médico. Microsoft lo plantea como una herramienta de apoyo a la decisión, que propone diagnósticos y pruebas para que los revise un profesional. El bioinformático Alfonso Valencia ya pedía poner en perspectiva los avances médicos de la IA ante la promesa de DeepMind de curar todas las enfermedades en diez años.
La siguiente prueba, con pacientes en Boston
Microsoft probará MAI-DxO en el Beth Israel Deaconess Medical Center con un estudio prospectivo, es decir, con pacientes que llegan en ese momento y no con historias ya resueltas. Todos recibirán la atención habitual de sus médicos. Los que acepten participar hablarán además con el sistema, y sus recomendaciones se compararán con las de esos médicos.
Suleyman presenta el resultado como un paso hacia lo que Microsoft llama superinteligencia médica y cree que los modelos de salud serán «un orden de magnitud» mejores en 24 a 36 meses. Google trabaja en un sistema parecido llamado AMIE, y OpenAI ya ofrece ChatGPT Health para interpretar análisis. Microsoft, además, entrena con la Clínica Mayo un modelo sanitario que prevé lanzar en 2027.
La conversación empieza aquí
Accede con una cuenta de apoyo para comentar. Entrar
Todavía no ha comentado nadie. ¿Estrenas tú?