Para pedir que no entrenen modelos de IA con tu web, añade unas líneas a robots.txt, el archivo de texto que consultan los rastreadores (los robots que recorren la web) antes de copiar tus páginas. Esas líneas cierran el sitio a los robots de entrenamiento de OpenAI, Anthropic, Google, Apple, Meta y Common Crawl. En WordPress.com y Cloudflare, un ajuste añade por ti sus propias reglas de bloqueo.
Las empresas que respetan el archivo dejan de entrenar con lo que recojan desde que lo cambias, pero ninguna promete retirar lo que ya tiene, y un rastreador que lo ignore seguirá entrando. Lo que escribes en los chatbots se protege aparte, como contamos en cómo impedir que entrenen con tus conversaciones.
Las líneas que hay que copiar
Pega estas líneas al final de tu robots.txt, una debajo de otra. Cada «User-agent» nombra a un robot, y varias seguidas comparten la regla de debajo, como permite el estándar del archivo, el RFC 9309. «Disallow: /» les cierra la web entera.
- User-agent: GPTBot
- User-agent: ClaudeBot
- User-agent: Google-Extended
- User-agent: Applebot-Extended
- User-agent: meta-externalagent
- User-agent: CCBot
- Disallow: /
Qué hace cada nombre
GPTBot, ClaudeBot, meta-externalagent y CCBot son los rastreadores de OpenAI, Anthropic, Meta y Common Crawl que Cloudflare clasifica como bots de entrenamiento. Google-Extended y Applebot-Extended no visitan tu web. Son nombres con los que pides a Google y Apple que no entrenen con lo que ya descargan sus robots de siempre.
Para adelantarte, añade tras una línea en blanco «User-agent: __usage_ai-training» con su propio «Disallow: /». Es la regla común que preparan Google, OpenAI, Microsoft y Anthropic, y ninguna empresa la aplica todavía. Microsoft empezará el 1 de febrero de 2027 y Google a principios de 2027.
Qué robots conviene dejar pasar
Las búsquedas con IA usan otros robots, así que puedes cerrar el entrenamiento sin desaparecer de sus respuestas. OpenAI muestra webs en ChatGPT con OAI-SearchBot, cuyo permiso es independiente del de GPTBot según su documentación de rastreadores. Anthropic separa igual a Claude-SearchBot, que indexa (recopila y ordena) páginas para su buscador, y a Claude-User, que entra cuando alguien pide a Claude leer una página. Si no los nombras, siguen pasando.
Bloquear Google-Extended no te quita del buscador ni cambia tu posición, según la lista de rastreadores de Google, pero sí impide que la app de Gemini consulte tus páginas al responder. Apple asegura que Applebot-Extended tampoco cuenta en su búsqueda. Meta, en cambio, usa su robot también para indexar contenido en sus productos, así que vetarlo puede ir más allá del entrenamiento.
WordPress
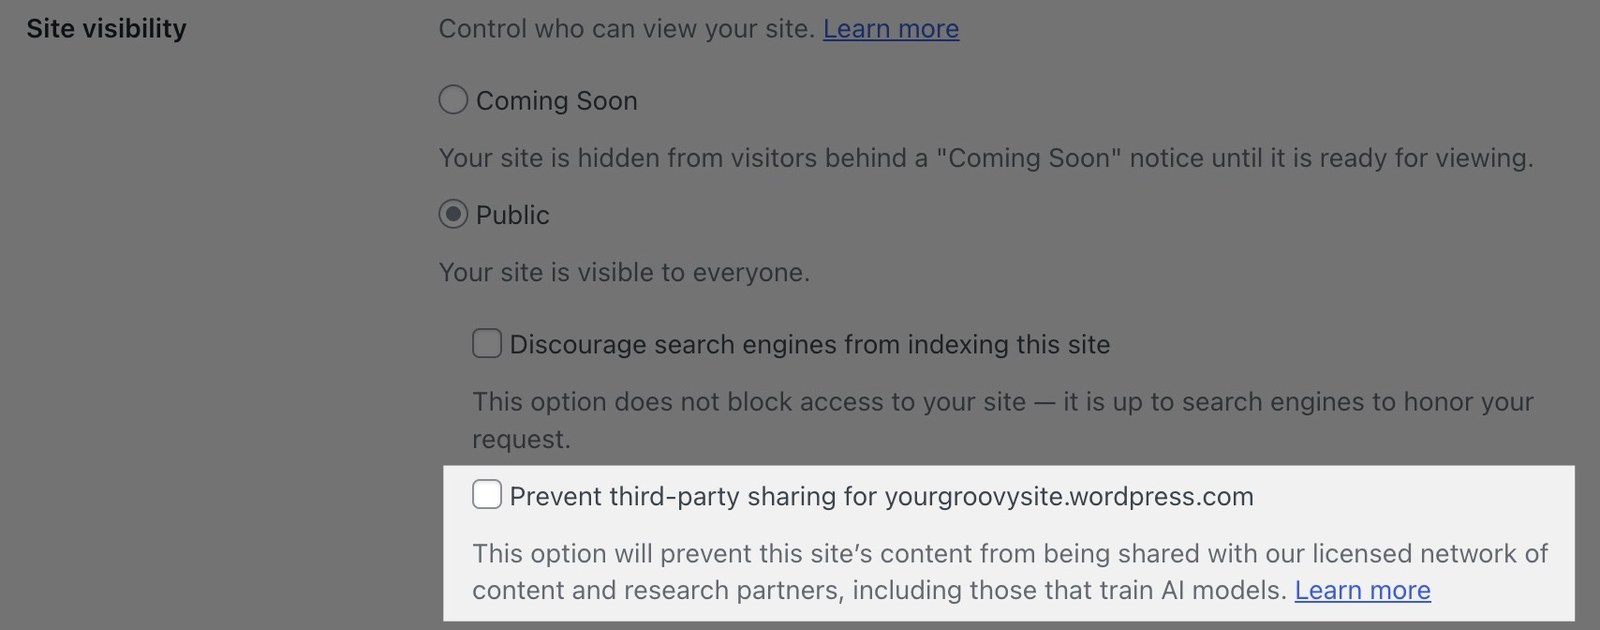
En WordPress.com, ve a Ajustes > Lectura, deja la visibilidad del sitio en Público, marca la casilla para no compartir con terceros (Prevent third-party sharing en inglés) y guarda. Según la ayuda de WordPress.com, la casilla añade los bots de IA conocidos a la lista de bloqueo de robots.txt. Hay que activarla en cada sitio.
Si instalaste WordPress en tu propio servidor, el plugin Yoast SEO crea o edita el archivo en Yoast SEO > Herramientas > Editor de archivos. Si ese menú no aparece, la edición de archivos está desactivada y la ayuda de Yoast remite a subirlo por FTP (el sistema para pasar archivos al servidor) a la carpeta principal de la web.
Wix
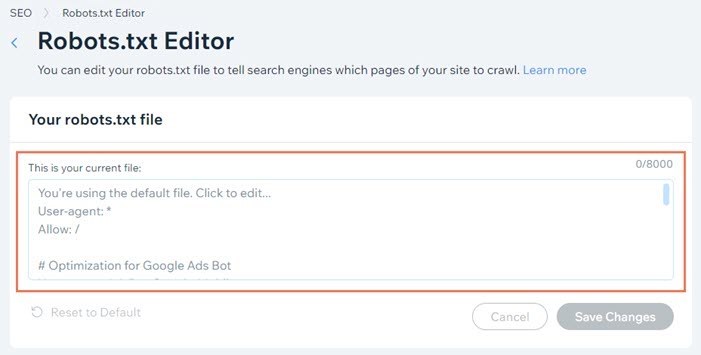
En Wix, abre SEO y GEO en el panel de control, baja hasta Herramientas y ajustes, entra en Editor de robots.txt y pulsa Ver archivo. Pega el bloque debajo del texto que ya hay, pulsa Guardar cambios y confirma con Guardar. Si algo sale mal, Restablecer ajustes predeterminados devuelve el archivo original. El soporte de Wix no ayuda con esos cambios.
Shopify
Shopify genera robots.txt con una plantilla del tema, el diseño de tu tienda. En el editor de código del tema, haz clic derecho en la carpeta Templates, crea un archivo nuevo y llámalo robots.txt.liquid. Copia primero el código de su documentación para temas, que conserva las reglas que tu tienda ya trae y que Shopify desaconseja borrar, y pega tu bloque debajo como texto normal.
Cloudflare
Si tu web usa Cloudflare, incluso gratis, el servicio escribe las reglas por ti. Abre Security Settings, filtra por Bot traffic, entra en Configure AI bot policies, pon Training en Disallow, activa Enable Bot Preference Sync y guarda. Según su documentación, sus reglas aparecen en segundos encima de tu robots.txt, o crean el archivo si no existía.
Para rechazar visitas, algo que robots.txt no hace, Cloudflare tiene en AI Crawl Control, pestaña Security, un botón Block junto a cada rastreador. En el plan gratuito solo reconoce a los robots por el nombre con el que se presentan, así que no frena a uno que oculte su identidad.
Cómo comprobar que ha funcionado
Escribe en el navegador la dirección de tu web seguida de /robots.txt, por ejemplo tuweb.com/robots.txt. Deberías ver tus líneas nuevas, o las de Cloudflare al principio. Los rastreadores pueden tardar hasta 24 horas en enterarse, porque el estándar les deja trabajar ese tiempo con una copia guardada. Cada subdominio, como blog.tuweb.com, necesita su propio robots.txt, según Anthropic.
Preguntas frecuentes
¿Bloquear GPTBot me saca de las búsquedas de ChatGPT?
No. OpenAI usa GPTBot para entrenar y OAI-SearchBot para mostrar webs en las búsquedas de ChatGPT, y trata cada permiso por separado. Puedes cerrar el paso a GPTBot y dejar entrar a OAI-SearchBot. Si cambias lo que permites a este último, OpenAI calcula que sus búsquedas tardan unas 24 horas en reflejarlo.
¿Bloquear Google-Extended empeora mi posicionamiento en Google?
No. Google afirma que Google-Extended no influye en que tu web aparezca en el buscador ni en su posición. Solo decide si lo que rastrea Googlebot puede usarse para entrenar futuros modelos Gemini y para que la app de Gemini consulte tus páginas al responder. Tus resultados normales de Google no cambian.
¿Robots.txt borra lo que la IA ya ha aprendido de mi web?
No. El archivo solo expresa tu preferencia a partir del momento en que lo cambias. Anthropic, por ejemplo, habla de excluir el material futuro, y ninguna de las empresas de esta guía promete retirar páginas que ya forman parte de un modelo entrenado. Cuanto antes añadas las líneas, menos contenido quedará expuesto.
¿Qué es __usage_ai-training y cuándo funcionará?
Es una regla común que nombra un uso, el entrenamiento, en lugar de un robot concreto. Con ella, dos líneas valdrían para varias empresas. Microsoft la leerá desde el 1 de febrero de 2027 y Google la admitirá a principios de 2027. OpenAI la aplicará en los próximos meses y Anthropic no ha dado fecha. Puedes añadirla ya sin perjuicio.
¿Pueden los bots de IA ignorar robots.txt?
Sí. Cumplirlo es voluntario, y Cloudflare lo recuerda en su propia documentación. Las empresas que se han comprometido a respetarlo lo harán, pero un rastreador desconocido o uno que oculte su identidad puede entrar igual. Para rechazar visitas de verdad hace falta un servicio como AI Crawl Control de Cloudflare, que bloquea en la red.
¿Cuánto tarda en hacer efecto el cambio?
El archivo se actualiza en cuanto lo guardas, y en Cloudflare las reglas aparecen en segundos. Lo que tarda es la reacción de los rastreadores, porque el estándar de robots.txt les permite guardar una copia hasta 24 horas. Meta y OpenAI dan ese mismo margen aproximado. Pasado un día, todos deberían estar leyendo la versión nueva.
La conversación empieza aquí
Accede con una cuenta de apoyo para comentar. Entrar
Todavía no ha comentado nadie. ¿Estrenas tú?