Una web podrá pedir con una sola regla que Google, OpenAI, Microsoft y Anthropic no usen su contenido para entrenar sus modelos de IA. OpenAI, Google y Microsoft anunciaron el viernes 30 de octubre que respetarán esa regla, que se escribe en robots.txt, el archivo con el que cada sitio da instrucciones a los programas que lo recorren. La propuesta es de Kevin Kelley, de Anthropic, que la ha enviado como borrador al IETF, el organismo que elabora los estándares técnicos de internet. Anthropic asegura que ya ha empezado a incorporarla.
Entrenar un modelo de IA es hacerle leer enormes cantidades de páginas para que aprenda de ellas a escribir y responder. Hasta ahora, quien no quería que su blog o su tienda se usara así tenía que escribir una regla para cada empresa, con nombres como GPTBot, Google-Extended o ClaudeBot.
Qué es robots.txt y qué hay que escribir
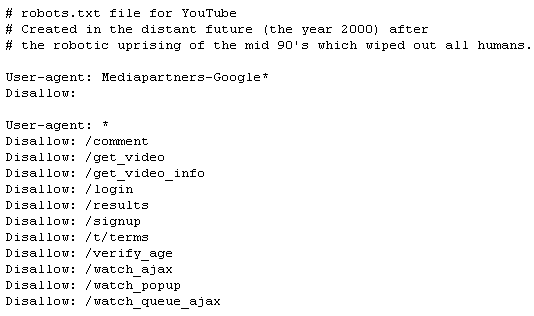
robots.txt es un archivo de texto que vive en la raíz de una web, por ejemplo en tuweb.com/robots.txt. Los rastreadores, los programas que copian páginas para un buscador o para una IA, lo consultan antes de entrar. Cada bloque empieza con «User-Agent», que dice a quién va dirigida la regla, y sigue con «Disallow», que marca las partes de la web vetadas.
La nueva regla nombra un uso en lugar de un robot concreto. Según el blog de Bing, para excluir toda la web basta con escribir «User-Agent: __usage_ai-training» y, debajo, «Disallow: /». La barra abarca todo el sitio, y para proteger solo una sección se pone su ruta, como «Disallow: /blog/». Si no añades nada, no expresas ninguna preferencia y cada empresa sigue con sus normas habituales.
Cuándo la respetará cada empresa
Microsoft es la única con fecha y leerá la regla en sus rastreos a partir del 1 de febrero de 2027. Google la admitirá «en 2027», y una web que la use para excluirse contará también como bloqueada para Google-Extended aunque no lo mencione. OpenAI prevé aplicarla «en los próximos meses». Anthropic no da fecha, y Kelley reconoce en la lista de correo del IETF que llevarla a todos sus servicios llevará tiempo.
Lo que esta regla no hace
Es una petición voluntaria. Solo la cumplirán las empresas que se han comprometido, y un rastreador que ya ignora robots.txt seguirá ignorándolo. El archivo nunca ha sido un candado, como se vio cuando chats compartidos de Claude aparecieron en Google pese a estar bloqueados en robots.txt.
Tampoco impide que los robots visiten tus páginas, porque el borrador la limita al entrenamiento, que define como cambiar lo que un modelo ha aprendido. Según el mismo texto, vale lo que dijera robots.txt el día en que se descargó cada página, así que añadir la regla hoy no retira lo que ya se haya usado.
Además, la regla no cubre que una IA lea tu página en el momento para componer una respuesta, lo que Microsoft llama grounding. Microsoft lo controla con una preferencia aparte en el código de cada página, y avisa de que excluirse con ella reduce la presencia de la web en Copilot, su asistente, y en sus otras respuestas de IA, aunque no la saca de los resultados normales de Bing.
Qué puedes hacer hoy si tienes una web o un blog
Puedes añadir ya las dos líneas comunes. No harán efecto hasta que cada empresa empiece a leerlas, pero así no tendrás que acordarte de volver al archivo. Mientras tanto, lo que funciona son las reglas de cada compañía, es decir, un bloque «User-Agent: GPTBot» con «Disallow: /» para OpenAI y otros iguales con Google-Extended y ClaudeBot para Google y Anthropic. Según las ayudas de OpenAI y Anthropic, bloquear sus robots de entrenamiento no te saca de las búsquedas de ChatGPT ni de Claude, porque esas búsquedas usan otros rastreadores, OAI-SearchBot y Claude-SearchBot.
Todo esto protege lo que publicas en tu web. Lo que escribes en ChatGPT, Gemini o Claude se controla en los ajustes de cada cuenta, como explicamos en cómo impedir que entrenen con tus conversaciones.
La conversación empieza aquí
Accede con una cuenta de apoyo para comentar. Entrar
Todavía no ha comentado nadie. ¿Estrenas tú?