Pew Research Center pidió a una IA que respondiera encuestas en lugar de personas reales y obtuvo una opinión pública bastante distinta. En casi 300 preguntas, las proporciones de respuestas simuladas se separaron de las humanas unos 12 puntos porcentuales de media. El informe se publicó el 30 de septiembre, pero los experimentos se hicieron entre febrero y mayo de 2026. Sus resultados principales usan Claude Opus 4.6 y adultos de Estados Unidos.
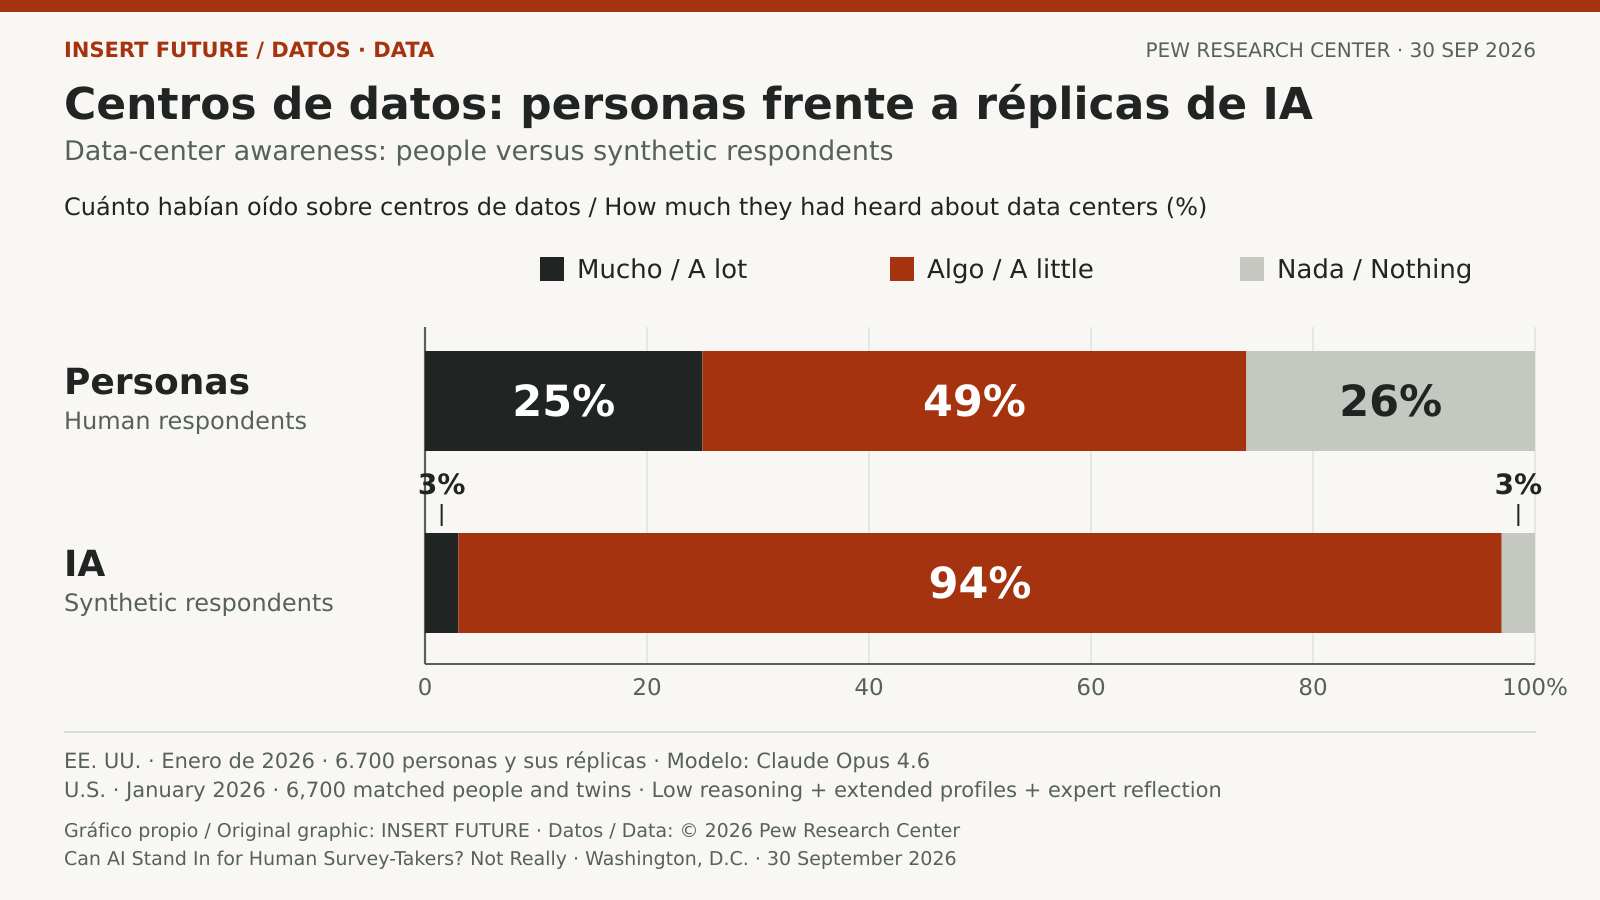
Una pregunta sobre centros de datos permite ver el problema. Entre las personas, el 25 % había oído mucho sobre ellos, el 49 % algo y el 26 % nada. En la simulación, esos grupos se convirtieron en un 3 %, un 94 % y un 3 %. La IA concentró casi a todos en la respuesta intermedia, aunque disponía de información sobre las personas a las que debía representar.
Cómo se construyeron los encuestados simulados
Los investigadores crearon un perfil para cada participante con datos demográficos y respuestas previas sobre sus ideas políticas. Añadieron una interpretación del perfil generada por GPT-5.1 y entregaron todo ese material al modelo que contestaba la encuesta. Era información incluida en las instrucciones, sin el entrenamiento adicional que explicamos en nuestra guía de ajuste fino de una IA. La prueba principal utilizó el ajuste de razonamiento bajo de Opus 4.6.
Cada copia simulada respondía una pregunta tras otra, conservaba sus respuestas anteriores y recibía el mismo idioma y orden de opciones que su persona de referencia. La metodología de Pew compara tres encuestas de enero, marzo y abril con grupos de 6.700, 3.398 y 4.981 participantes. Solo incluye a quienes habían completado también el cuestionario previo usado para construir los perfiles.
Los aproximadamente 12 puntos miden la distancia entre porcentajes de respuesta. Pew calcula la diferencia para cada opción, sin importar si la IA se pasa o se queda corta, y después promedia opciones y preguntas. No significa que el modelo fallara el 12 % de las preguntas ni que esa cifra sea el margen de error de una encuesta.
Saber la respuesta también puede estropear la simulación
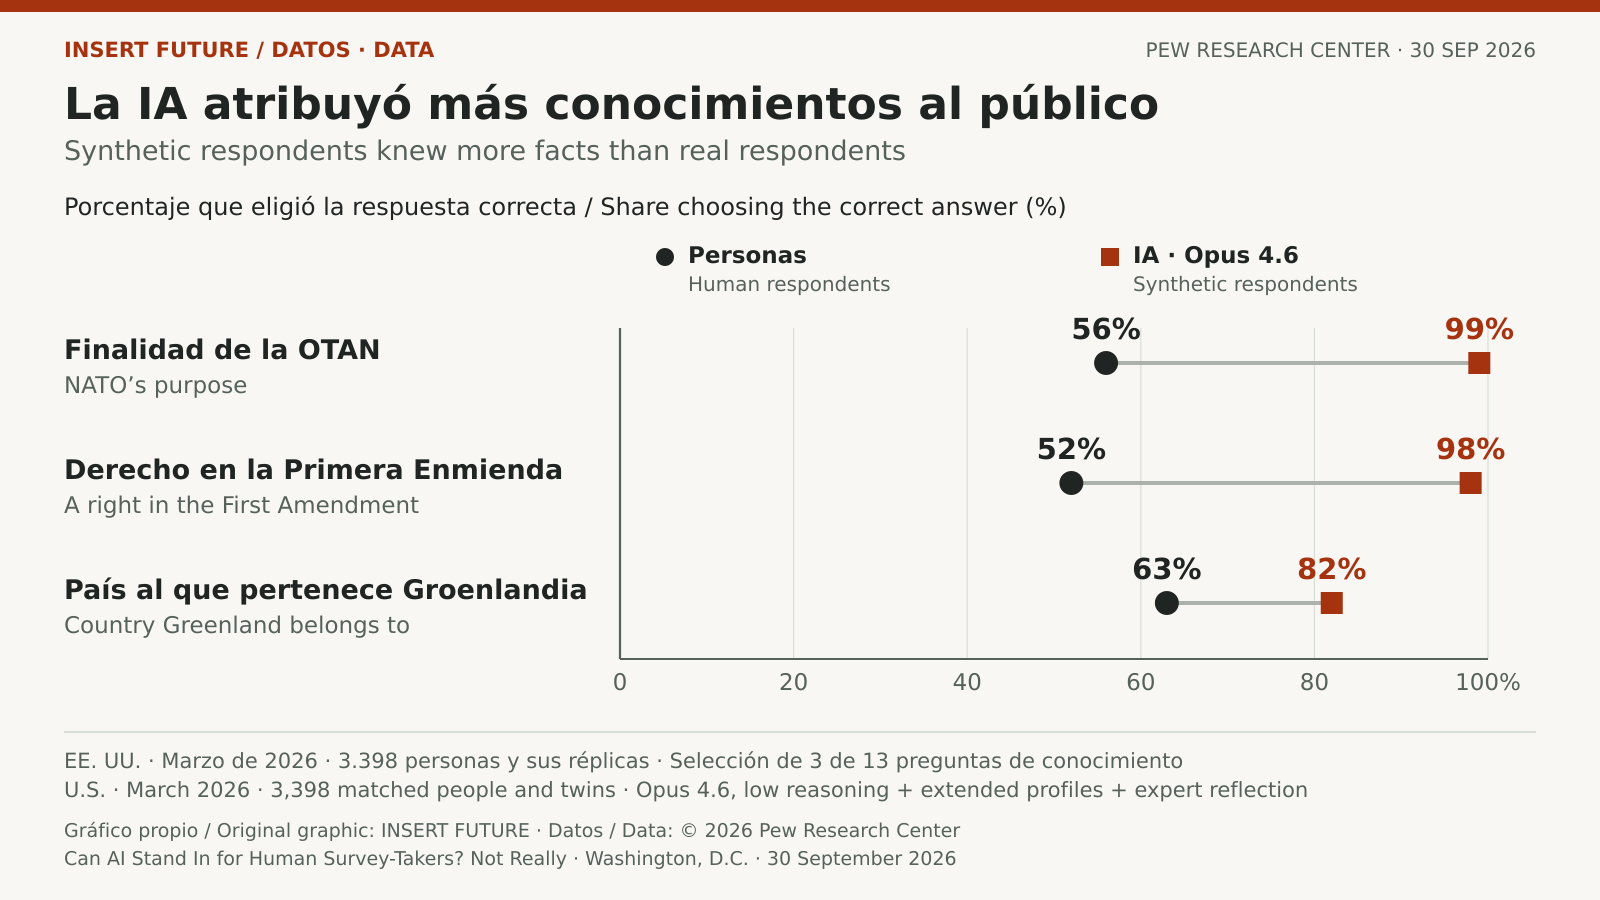
En las preguntas de conocimientos, la IA solía acertar más que las personas que estaba imitando. El 56 % de los participantes identificó correctamente la finalidad de la OTAN, frente al 99 % de sus copias simuladas. La tarea consistía en reproducir lo que sabía esa población, de modo que atribuir casi pleno conocimiento a todo el mundo empeoraba el resultado.
Tampoco imitó bien las dudas. En las preguntas de opinión que permitían elegir una respuesta de incertidumbre, las personas la marcaron de media un 16 % de las veces y la simulación un 4 %. La simulación deja menos espacio para la incertidumbre que expresaron las personas.
El gráfico recoge tres preguntas de las 13 usadas para comprobar conocimientos. Sus porcentajes de acierto describen ese ejercicio concreto, no una puntuación de inteligencia del modelo.
Cambiar de modelo cambia la opinión que aparece
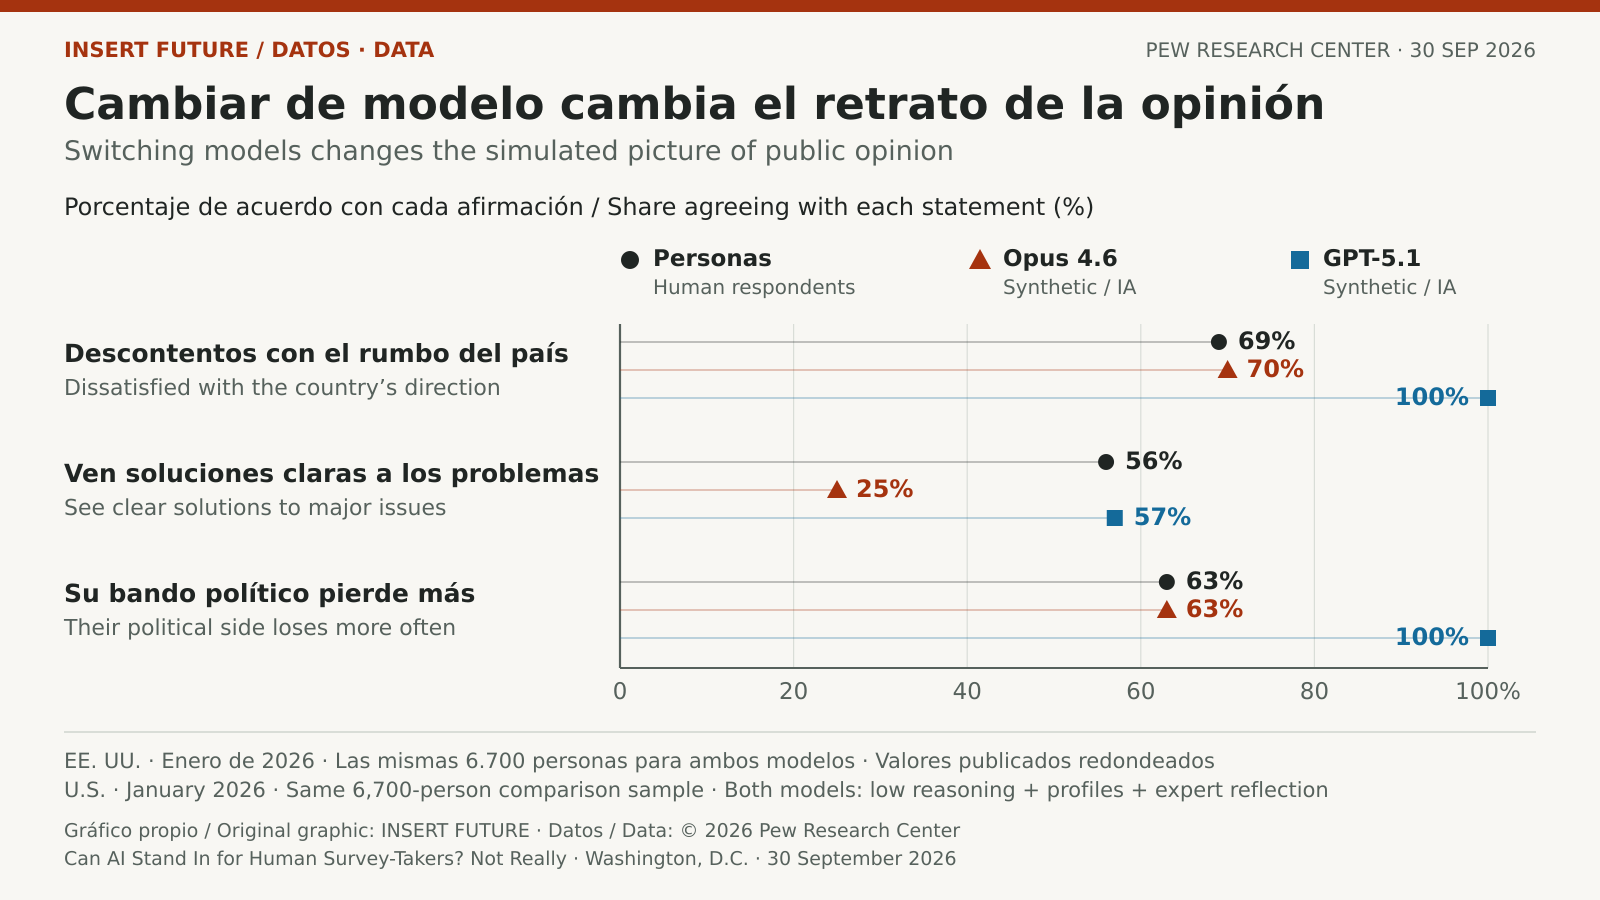
Pew repitió la encuesta de enero con GPT-5.1 y Claude Opus 4.6 sobre el mismo grupo de 6.700 personas. El 69 % de los participantes estaba descontento con el rumbo del país. Opus estimó un 70 % y GPT un 100 %, según los valores redondeados publicados.
En otra pregunta se invirtió la ventaja. El 56 % de las personas veía soluciones claras para los grandes problemas nacionales. GPT estimó un 57 %, mientras Opus se quedó en el 25 %. Elegir el modelo podía cambiar mucho la imagen de la población, y el que acertaba mejor en una pregunta no tenía por qué hacerlo en la siguiente.
Qué permite concluir esta prueba
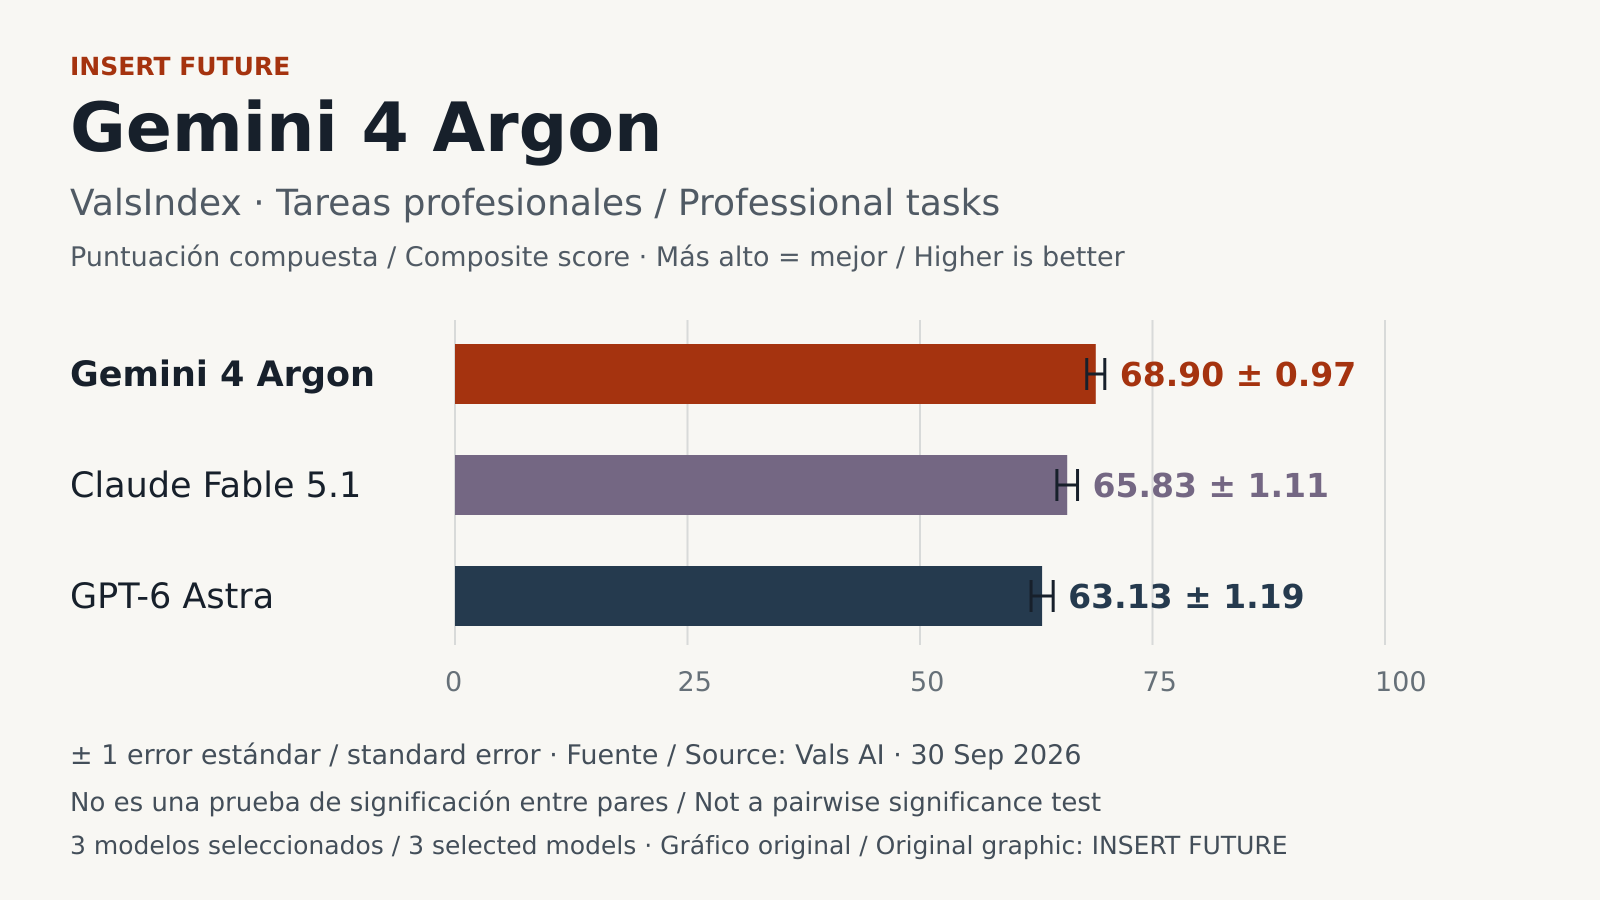
El estudio evalúa una forma concreta de simular encuestados, con modelos anteriores a lanzamientos como Gemini 4 Argon. No prueba cómo responderían las versiones más recientes ni reproduce una encuesta española. Además, la referencia humana es una muestra ponderada para representar a la población, también expuesta a errores de muestreo y de medición.
Pew concluye que este método no sustituye a preguntar a las personas. El centro sí utiliza IA para otras tareas, como clasificar respuestas abiertas o ayudar a escribir código de análisis, según su política de uso. Esos usos conservan las respuestas humanas como material de trabajo.
La conversación empieza aquí
Accede con una cuenta de apoyo para comentar. Entrar
Todavía no ha comentado nadie. ¿Estrenas tú?