Un agente en la nube con una sola llamada
OpenAI ha lanzado Agents API en beta pública para que los desarrolladores construyan agentes sobre el mismo arnés que sostiene Codex. Una petición define tarea, modelo, herramientas y entorno. El servicio conserva la sesión, transmite el progreso y coordina el trabajo prolongado.
El anuncio oficial pone el foco en tareas que duran horas o días. No es otro nombre para una respuesta larga: el agente puede trabajar con archivos, ejecutar código, guardar resultados intermedios, recuperarse y continuar a través de varias ventanas de contexto.
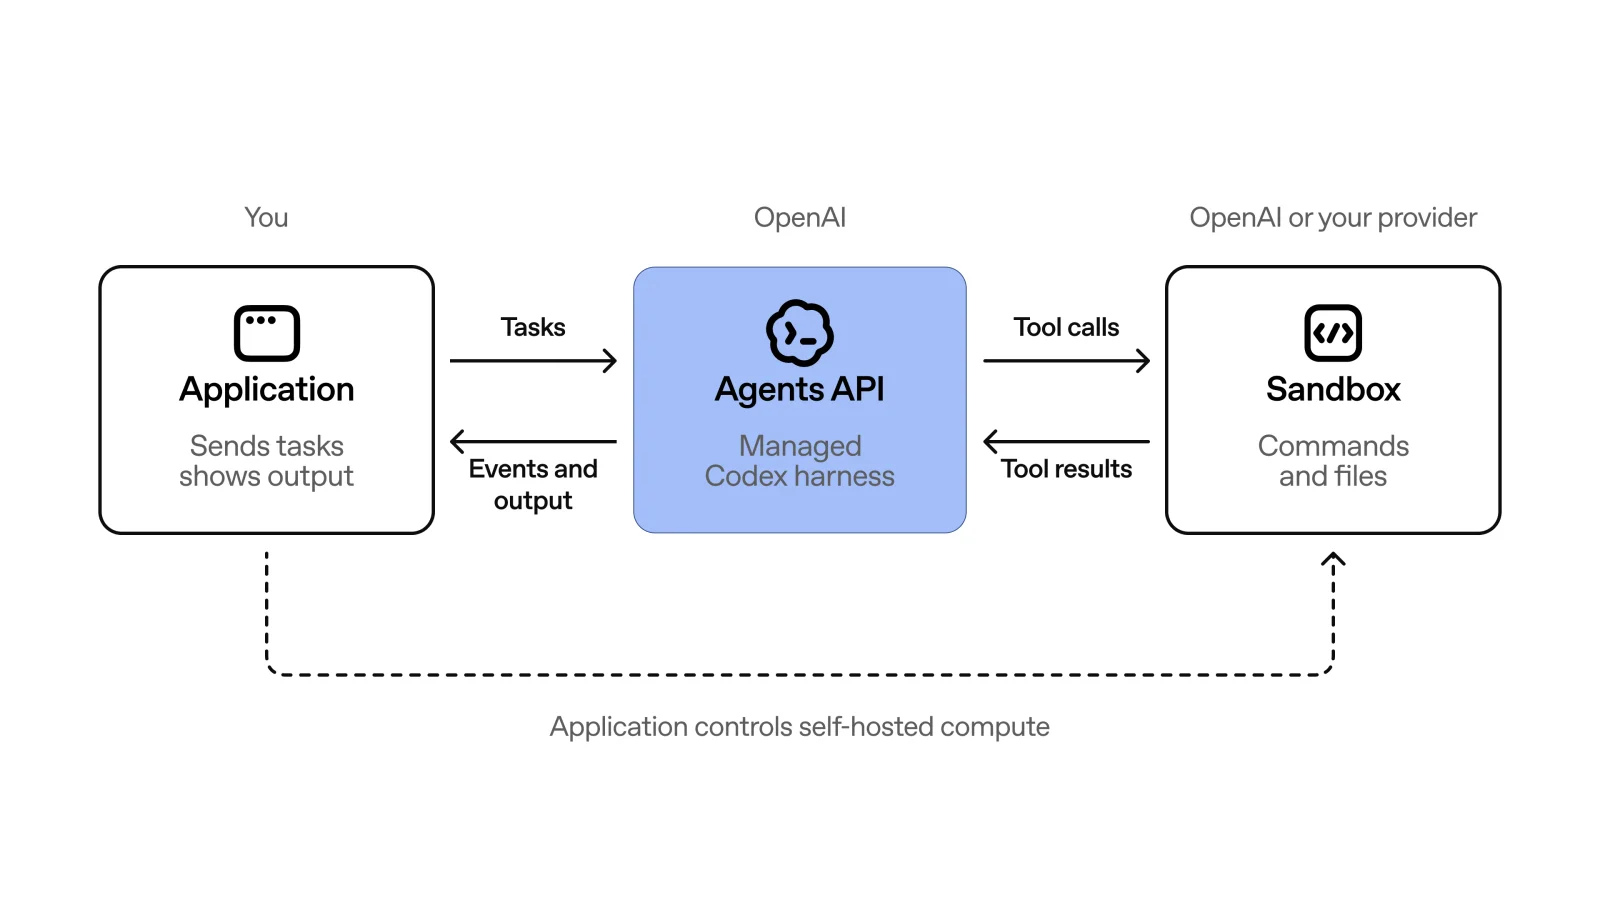
El arnés y el ordenador están separados
OpenAI aloja y mantiene la lógica que organiza modelo, contexto y herramientas, pero el desarrollador decide dónde se ejecuta el trabajo. Puede usar un sandbox gestionado por OpenAI, infraestructura propia o proveedores como Cloudflare, Daytona, E2B, Modal, Oracle, Runloop y Vercel.
Separar ambas capas permite acercar los datos al entorno adecuado y elegir CPU, GPU, memoria o almacenamiento. El sandbox de OpenAI incluye archivos, paquetes, skills y plugins. La arquitectura se parece a la que describimos al explicar cómo funcionan los agentes de IA, pero ahora llega empaquetada como servicio.
Contexto, MCP y subagentes
Agents API compacta el contexto cuando la sesión se acerca al límite, carga herramientas solo cuando hacen falta y admite llamadas programáticas para ejecutar operaciones en paralelo o filtrar resultados antes de devolverlos al modelo. Es compatible con MCP, funciones propias y herramientas integradas como búsqueda web.
También puede dividir una tarea en subagentes con contextos separados. Eso reduce interferencias entre investigaciones o ramas de código, mientras el agente principal coordina el resultado. No garantiza que el trabajo sea correcto: evaluación, límites de permisos y revisión siguen siendo responsabilidad de quien construye el producto.
Disponibilidad y precio
La beta está disponible para todos los desarrolladores. OpenAI no añade una tarifa específica por usar Agents API: se pagan los tokens del modelo y las herramientas consumidas. Ese matiz importa porque una sesión larga, varios subagentes y un sandbox potente pueden elevar el coste aunque el acceso a la API no tenga recargo.
El producto aterriza junto a GPT-6 Astra, cuyo rendimiento y enfoque en agentes ya analizamos. Antes de llevarlo a producción conviene fijar presupuestos, tiempos máximos, permisos por herramienta y pruebas reproducibles. También hay que registrar qué acción ejecutó cada agente y con qué evidencia, porque una sesión más duradera amplía tanto la utilidad como la superficie de error. La infraestructura resuelve parte de la orquestación. No decide qué riesgo acepta cada aplicación.
La conversación empieza aquí
Accede con una cuenta de apoyo para comentar. Entrar
Todavía no ha comentado nadie. ¿Estrenas tú?