Ai2 ha presentado Olmo-core 3, una nueva versión de su software abierto para entrenar modelos de inteligencia artificial. El cambio permite ampliar las partes del modelo disponibles para aprender sin que moverlas entre chips se coma buena parte de la velocidad. Universidades y otros equipos pueden examinar el código, modificarlo y usarlo en sus propios experimentos.
La mejora se dirige a quienes construyen una IA. Entrenar consiste en ajustar los valores numéricos con los que el modelo procesa información, como explicamos en la guía sobre entrenamiento y fine-tuning. Olmo-core organiza ese trabajo en las GPU, los chips que realizan los cálculos. No es una nueva aplicación de chat.
Más expertos disponibles, cuatro trabajando por fragmento
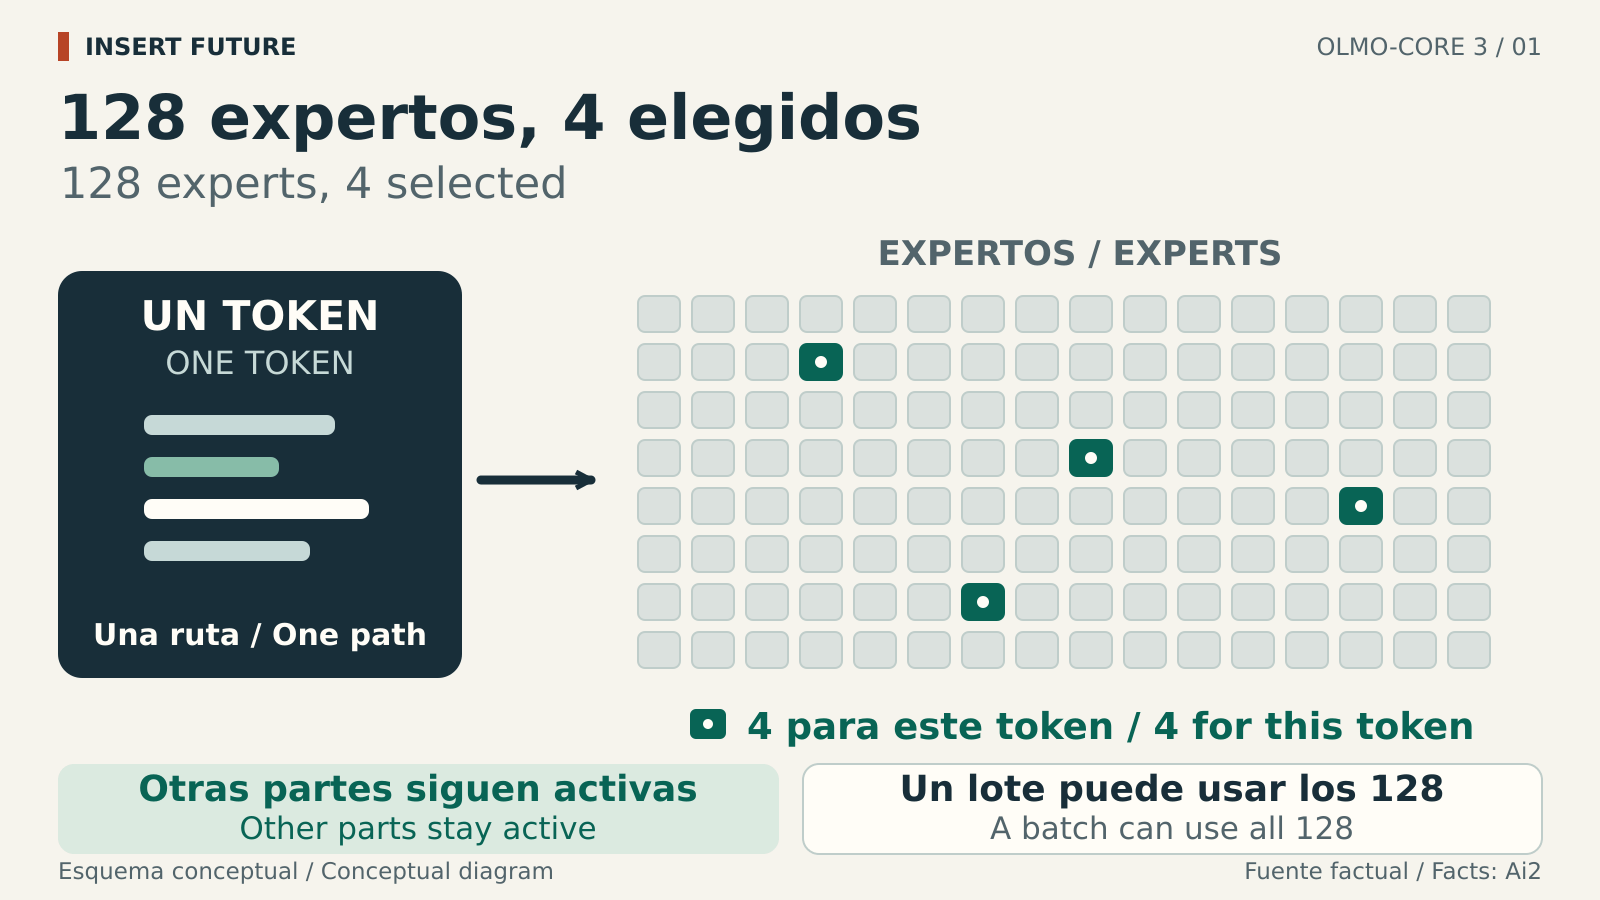
Los modelos de mezcla de expertos dividen parte de sus cálculos entre varios módulos. Para cada token, un pequeño fragmento de texto, un selector decide qué módulos usar. Tener más módulos disponibles permite aumentar el tamaño total del modelo sin activar todos a la vez. Un lote de texto sí puede acabar utilizando todos los expertos.
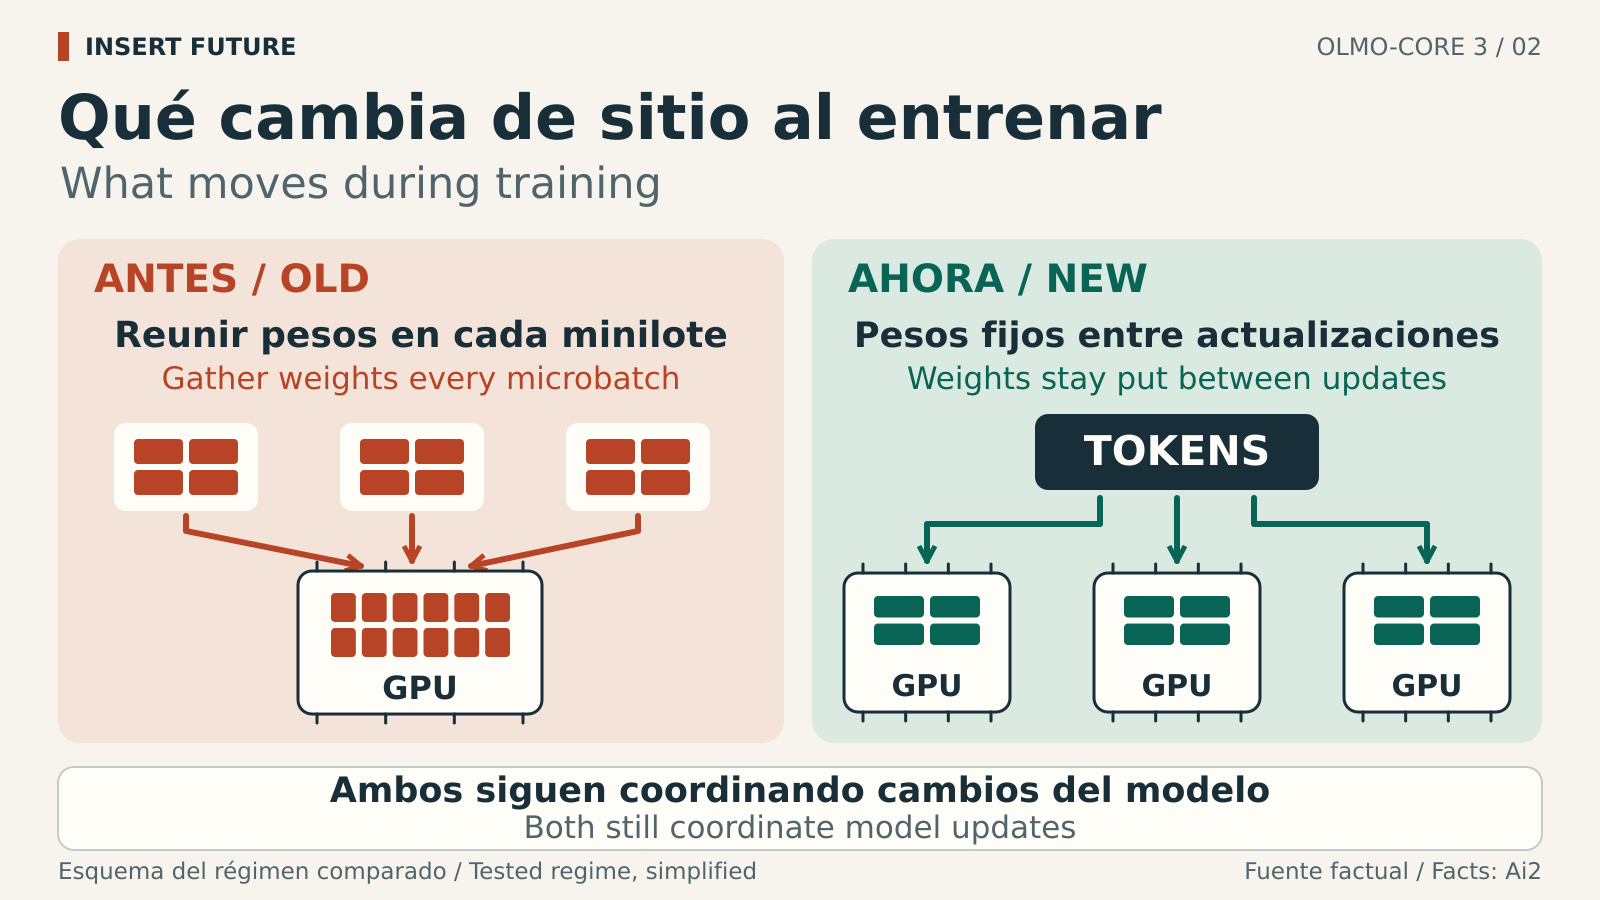
El problema aparece al entrenarlos. El sistema anterior reunía y volvía a repartir los valores del modelo para cada pequeño lote de datos. Aunque un fragmento solo necesitara cuatro expertos, transportar esos valores seguía consumiendo tiempo. Olmo-core 3 mantiene las partes de los expertos en sus GPU mientras acumula el trabajo previo a una actualización y envía los datos hacia ellas. Después sigue siendo necesario coordinar y actualizar el modelo.
Qué demuestran las pruebas de velocidad
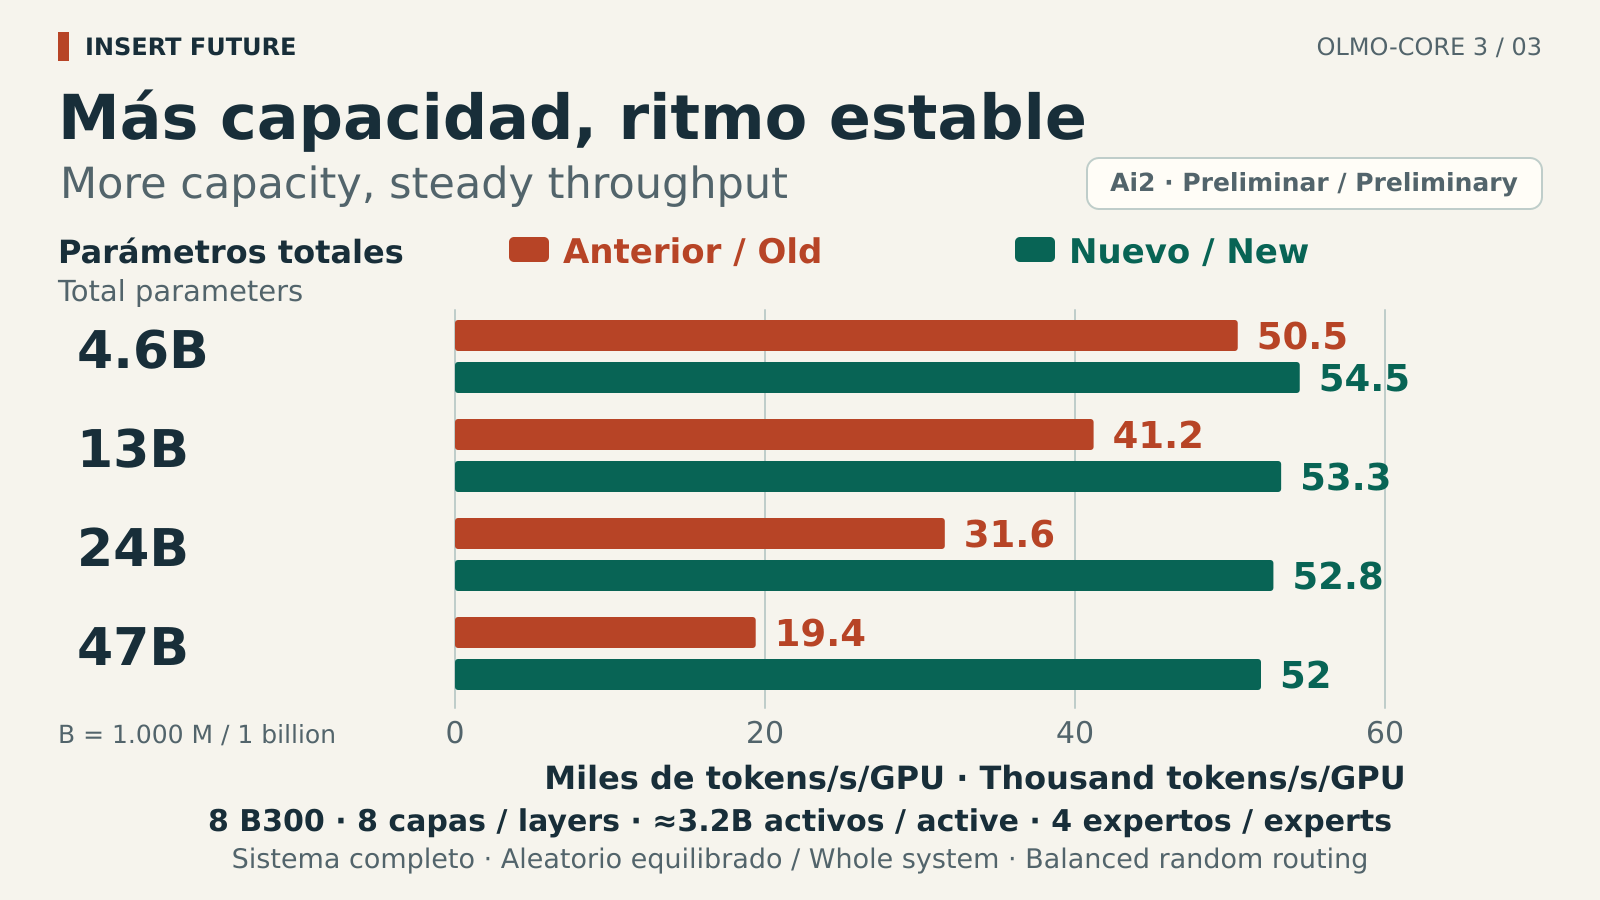
En el informe técnico de Ai2, una prueba con ocho GPU NVIDIA B300 amplió el grupo de 8 a 128 expertos y mantuvo cuatro seleccionados por token. El modelo pasó de 4.600 a 47.000 millones de parámetros, los valores que aprende, mientras la parte activa se mantuvo cerca de 3.200 millones. El nuevo sistema procesó 54.500 y 52.000 tokens por segundo y GPU, respectivamente. La pérdida de velocidad fue del 4,6% pese a multiplicar por diez el tamaño total.
Con el modelo de 47.000 millones, el sistema anterior alcanzaba 19.400 tokens por segundo y GPU. Los 52.000 del nuevo suponen unas 2,7 veces ese ritmo. Es una comparación entre las dos versiones de Olmo-core con varios cambios combinados, no una victoria sobre todos los programas de entrenamiento.
La prueba repartía la carga de forma aproximadamente equilibrada. Con textos reales, algunos expertos pueden recibir más trabajo y frenar al conjunto. Además, contar cuánto texto se procesa no demuestra que el modelo entrenado responda mejor ni fija cuánto costará completar su aprendizaje.
El código ya se puede estudiar y reutilizar
El repositorio oficial publica el código bajo licencia Apache 2.0. Su registro fecha la versión 3.0.0 el 30 de septiembre, aunque el anuncio detallado de Ai2 llegó el 1 de octubre. La organización prevé usar esta infraestructura para su próxima generación de Olmo. Las mediciones actuales permiten estudiar cómo entrenarla con menos sobrecarga, pero todavía no evalúan la calidad de ese futuro modelo.
La conversación empieza aquí
Accede con una cuenta de apoyo para comentar. Entrar
Todavía no ha comentado nadie. ¿Estrenas tú?