Ataraxos ya había ganado a uno de los grandes campeones de Stratego. El paso que documenta el estudio publicado en Nature el 30 de septiembre es aplicar su método a otros tres juegos. Los investigadores entrenaron sistemas distintos que vencieron a campeones humanos en Barrage Stratego y mejoraron los resultados de otras IA en los juegos de cartas Hanabi y dou dizhu.
La victoria en el Stratego clásico figuraba en un trabajo preliminar de noviembre de 2025. La ampliación permite comprobar si el método funciona cuando cambia la relación entre jugadores. En Stratego hay que derrotar al rival, en Hanabi todos colaboran y en dou dizhu dos participantes se alían contra un tercero. No es un único modelo que salte de un juego a otro sin entrenamiento.
Cómo juega sin saber qué esconde el rival
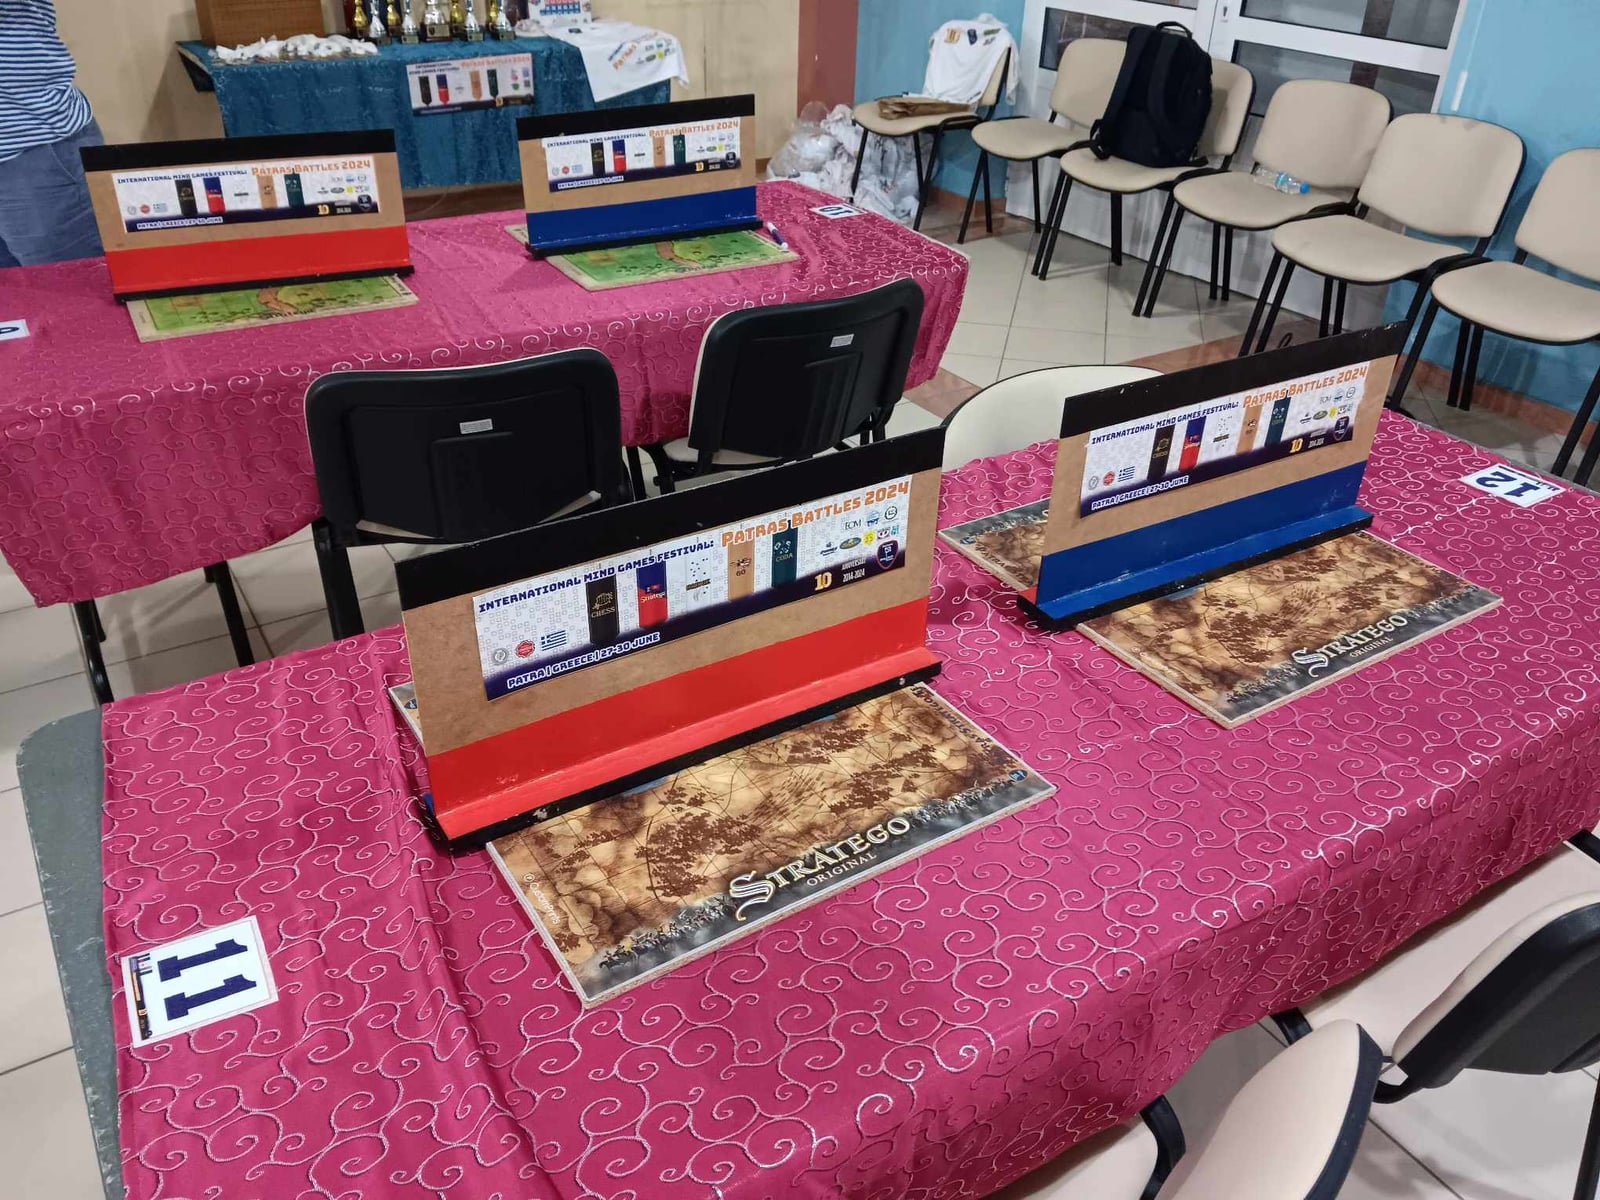
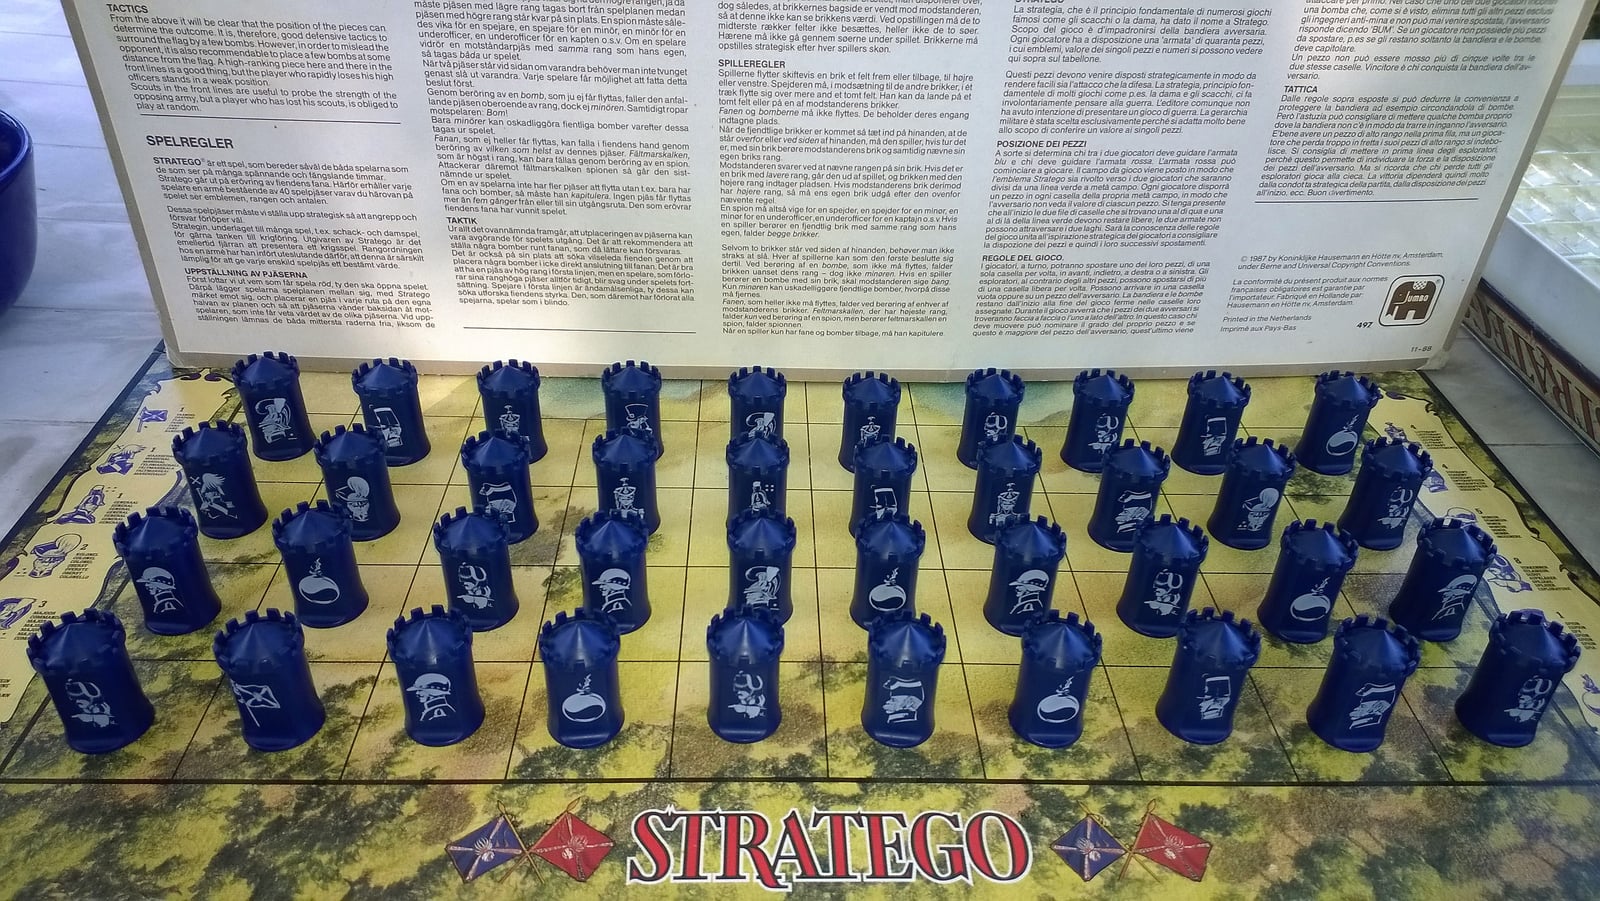
En Stratego, cada jugador coloca 40 piezas sin enseñar su identidad al contrario. Sabes dónde está una pieza enemiga, pero puedes ignorar si es débil, poderosa o una bomba hasta que entra en combate. Elegir un movimiento exige valorar lo que podría esconder el tablero y evitar que tus propias jugadas revelen demasiado.
Ataraxos aprende primero enfrentándose a copias de sí mismo. Tras muchas partidas, aumenta la probabilidad de elegir las decisiones que llevan a ganar. Eso es aprendizaje por refuerzo mediante autojuego. El equipo controla cuánto cambia la estrategia durante ese proceso para que aprender de una partida no deshaga los avances anteriores.
Antes de mover, otro componente estima identidades posibles para las piezas ocultas a partir de la información disponible. Ataraxos ensaya jugadas sobre varios de esos tableros posibles, calcula cómo podrían continuar y ajusta su elección. No necesita acertar qué es cada pieza para comparar riesgos. Esta IA aprende a jugar, una tarea diferente de generar diálogos o mejorar los gráficos, otros usos de la IA en videojuegos.
Ganar a personas y superar a otras IA
La prueba original de Stratego enfrentó al sistema a Pim Niemeijer, cuatro veces campeón del mundo. Ataraxos obtuvo 15 victorias, una derrota y cuatro empates en 20 partidas. Niemeijer podía estudiar al rival entre partidas, mientras que el sistema no se entrenaba de nuevo para adaptarse a él.
En Barrage Stratego, donde cada bando tiene ocho piezas en lugar de 40, el equipo disputó cuatro series de 50 partidas contra tres bicampeones mundiales. Sus sistemas ganaron las cuatro series. Tres usaron la estrategia aprendida sin la búsqueda adicional antes de mover y la cuarta incorporó esa búsqueda.
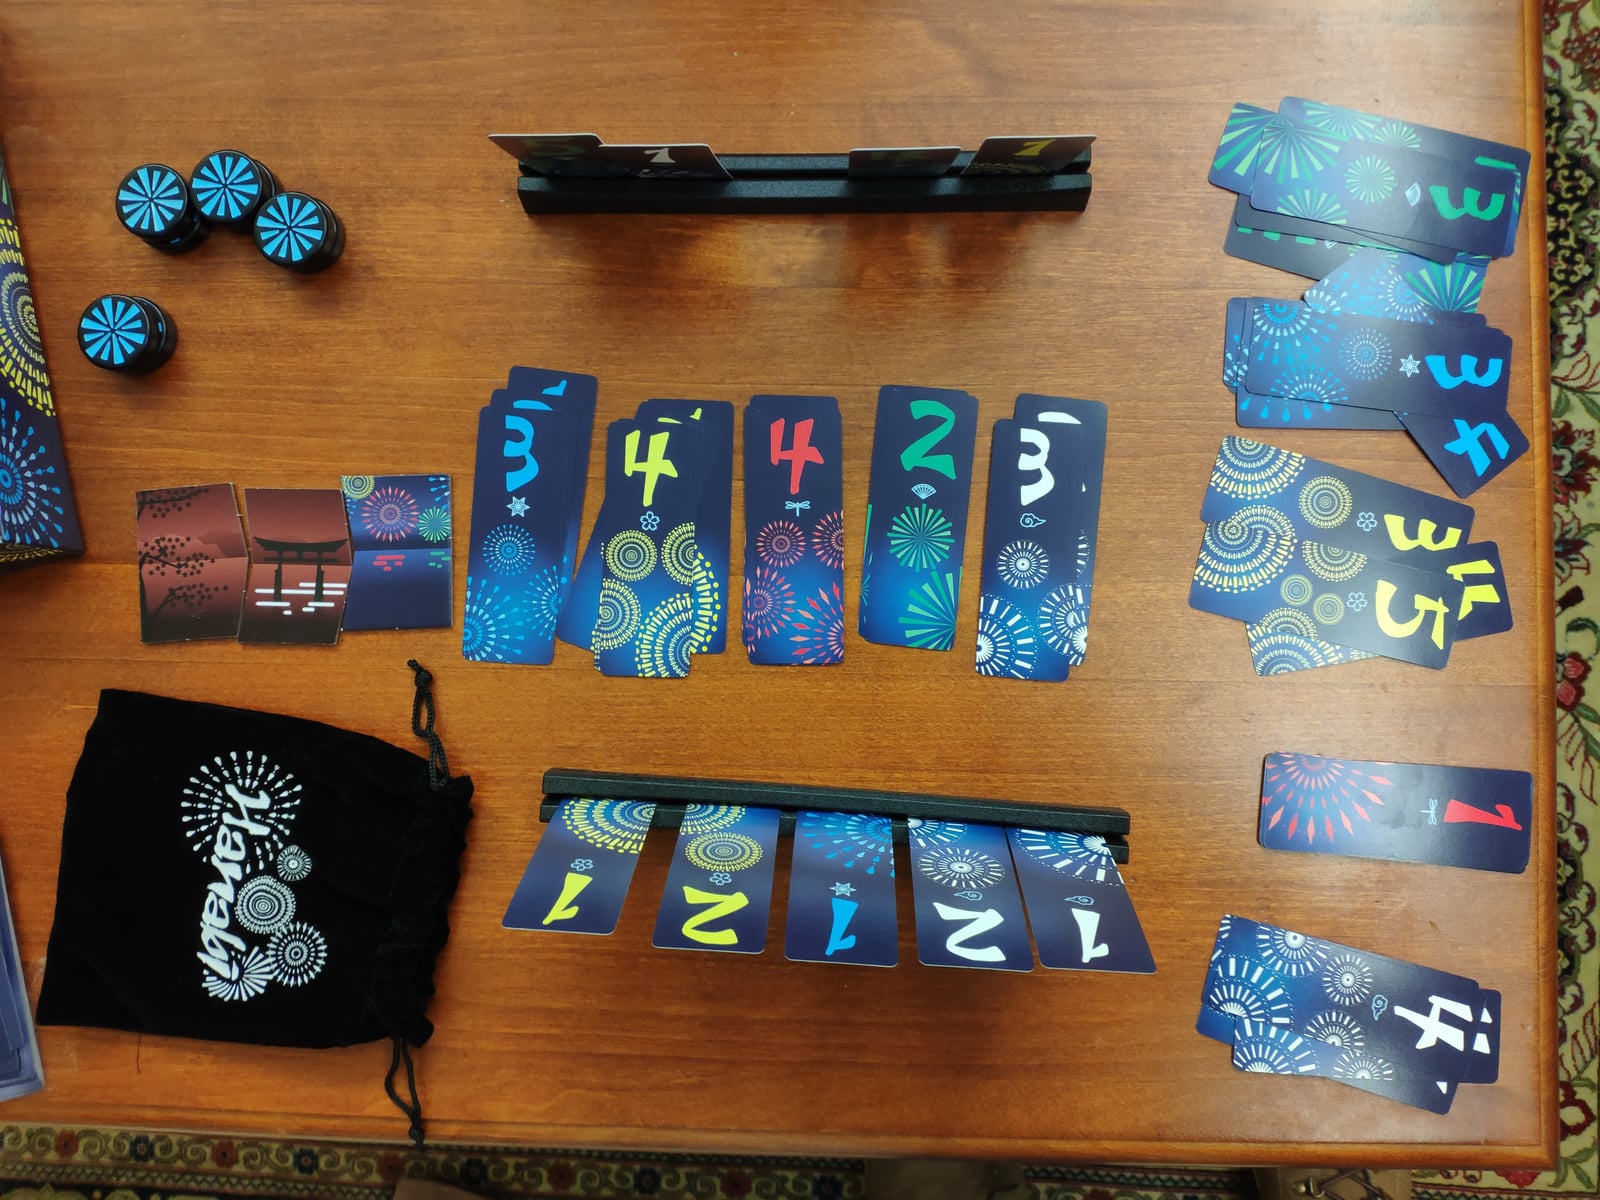
Hanabi plantea el problema contrario. Cada participante ve las cartas de los demás, pero no las suyas, y el grupo debe construir cinco secuencias de colores en orden. En las pruebas de cinco jugadores, Ataraxos completó la puntuación perfecta en aproximadamente el 58% de las partidas, frente al 32,9% del mejor resultado previo que recoge el estudio. Cada condición se evaluó en 10.000 partidas.
En dou dizhu, el objetivo es quedarse sin cartas. Un jugador se enfrenta a otros dos que cooperan, y Ataraxos superó a los programas PerfectDou y DouZero. Los resultados de Hanabi y dou dizhu son comparaciones con otras IA, no duelos ganados a campeones humanos.
Entrenar exige hardware y un buen simulador
Para el Stratego clásico, los autores calculan menos de 8.000 dólares de coste de entrenamiento con tarifas de 2025. Es una estimación del uso de hardware, no del presupuesto completo de la investigación. El sistema empleó 16 aceleradores NVIDIA H100 durante una semana para aprender a jugar y cuatro durante cuatro días para aprender a estimar las piezas ocultas.
El equipo aceleró el entrenamiento con un simulador que ejecuta millones de cambios del tablero por segundo. Practicar requiere que ese entorno responda rápido y respete las reglas. La importancia de entrenar en una representación fiable también aparece en Qwen-AgentWorld, aunque allí se simulan herramientas y ordenadores, no partidas de Stratego.
Pasar a negociaciones o ciberseguridad sigue siendo una posibilidad de investigación. No basta con trasladar las victorias del tablero a esos ámbitos, donde construir una simulación fiel puede ser mucho más difícil. En la presentación del MIT, los investigadores señalan además que quieren hacer comprensibles las decisiones de Ataraxos para que una persona pueda examinarlas antes de seguir sus recomendaciones.
La conversación empieza aquí
Accede con una cuenta de apoyo para comentar. Entrar
Todavía no ha comentado nadie. ¿Estrenas tú?